В этом обзоре рассматривается LattePanda Mu Ultra — компактный вычислительный модуль x86, предназначенный для приложений ИИ на устройстве. Он выпускается в двух версиях: с процессором Intel Core Ultra 5 226V или Core Ultra 7 256V. Обе модели оснащены 16 ГБ высокоскоростной памяти LPDDR5X, работающей на частоте 8533 MT/s, а старшая модель обеспечивает до 115 TOPS суммарной вычислительной мощности для ИИ.
В рамках обзора на LattePanda Mu Ultra была установлена Ubuntu 26.04, а тестирование выполнялось с помощью различных инструментов, включая sbc-bench, Geekbench 7 и Geekbench AI. Также проверялась производительность CPU, GPU и NPU с llama.cpp и YOLO26 для оценки возможностей в приложениях ИИ. В завершение была создана занимательная демонстрация, объединяющая YOLO26, MediaPipe и OpenCV, для проверки производительности компьютерного зрения в реальном времени, включая корректировку изображения жестами рук, с использованием USB-веб-камеры.
Распаковка LattePanda Mu Ultra
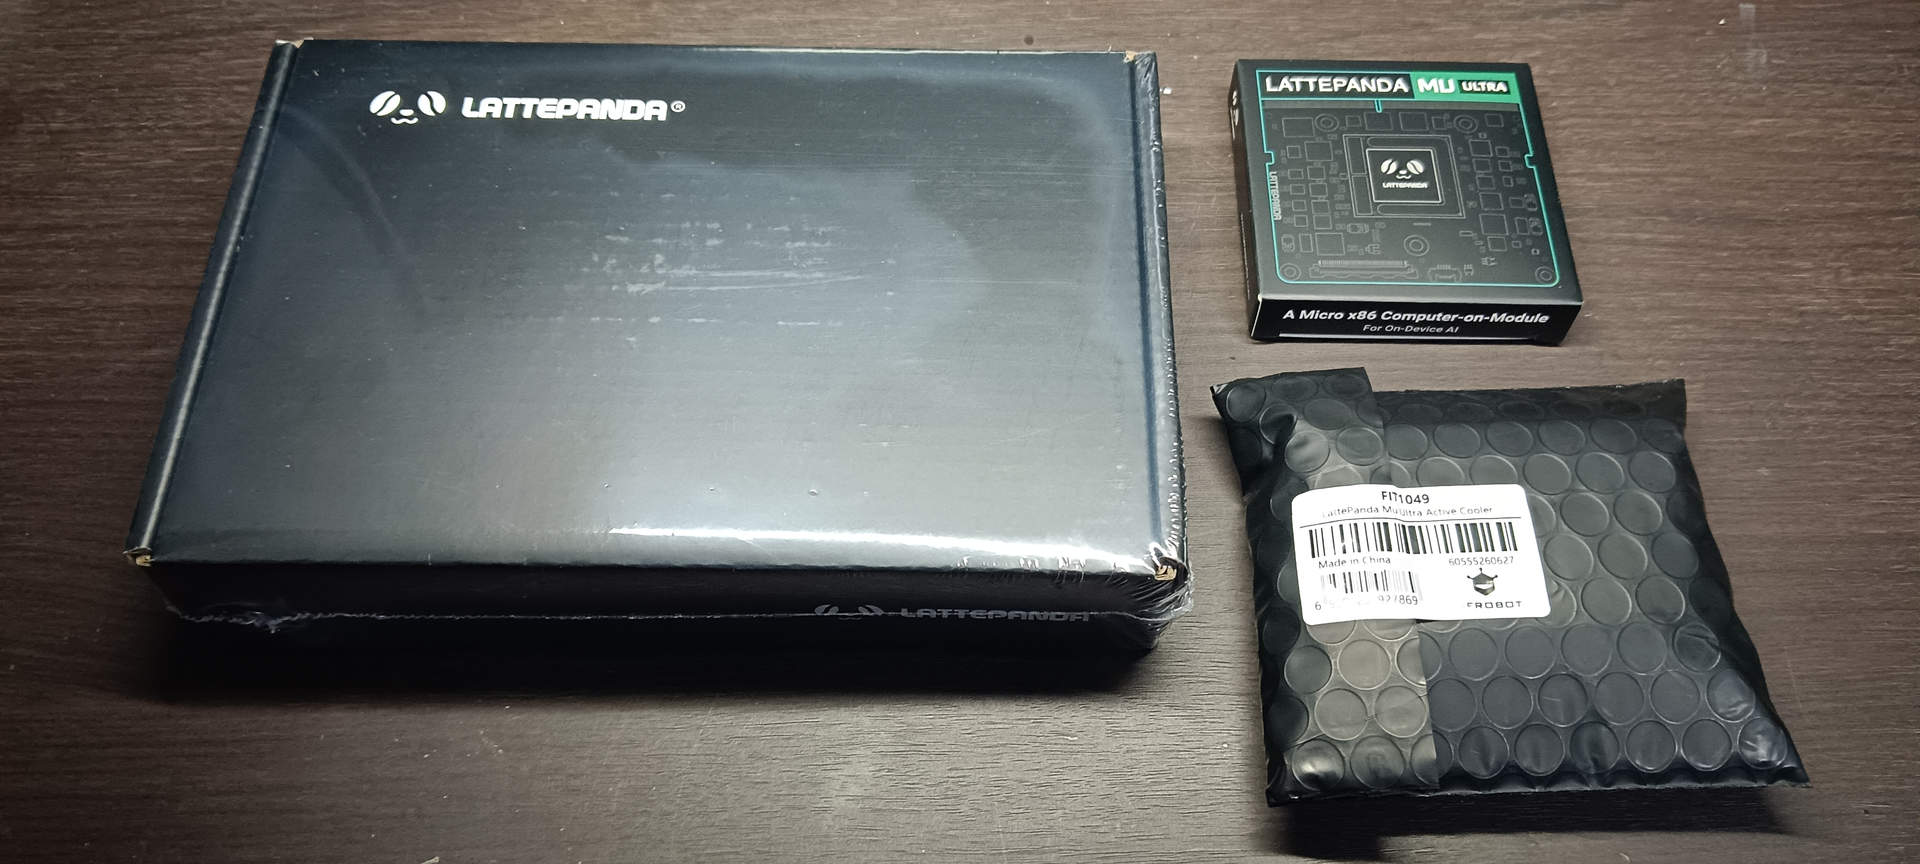
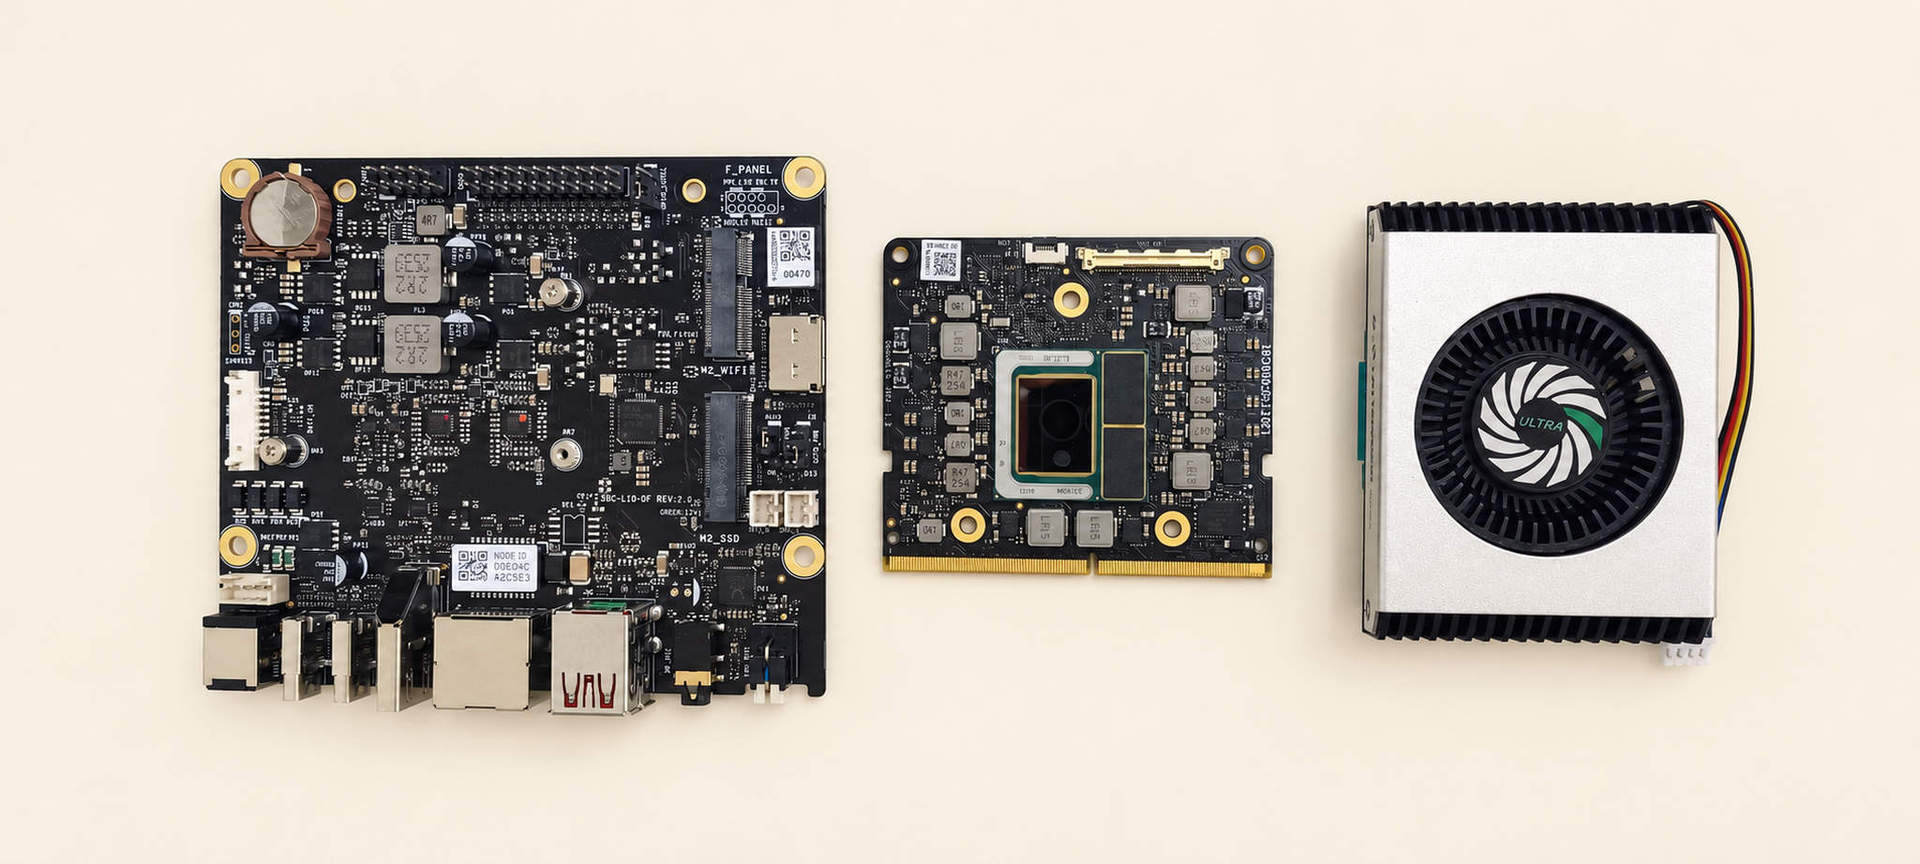
Посылка была отправлена из Китая и прибыла примерно через пять дней. Все компоненты поставлялись в стандартной картонной коробке с большим количеством пеноматериала для защиты при транспортировке. Был получен вариант на базе процессора Intel Core Ultra 7 256V. Производитель также прислал Mini Carrier Board для LattePanda Mu & Mu Ultra и Aluminum Active Cooler для LattePanda Mu Ultra. Всё было хорошо упаковано и прибыло в хорошем состоянии, без видимых повреждений, как показано на следующем изображении.
Настройка комплекта
Первоначальная настройка
Производитель предоставляет подробные инструкции по установке и настройке на официальной странице документации продукта . Инструкции были соблюдены, и настройка прошла гладко без серьезных проблем. Сначала радиатор был прикреплен к модулю LattePanda Mu Ultra, затем модуль был установлен на плату-носитель. Далее был установлен M.2 NVMe SSD для операционной системы и хранения данных. Поскольку SSD не входил в комплект, был повторно использован WD Blue SN5000 500 ГБ M.2 NVMe SSD из одного из предыдущих обзоров аппаратного обеспечения
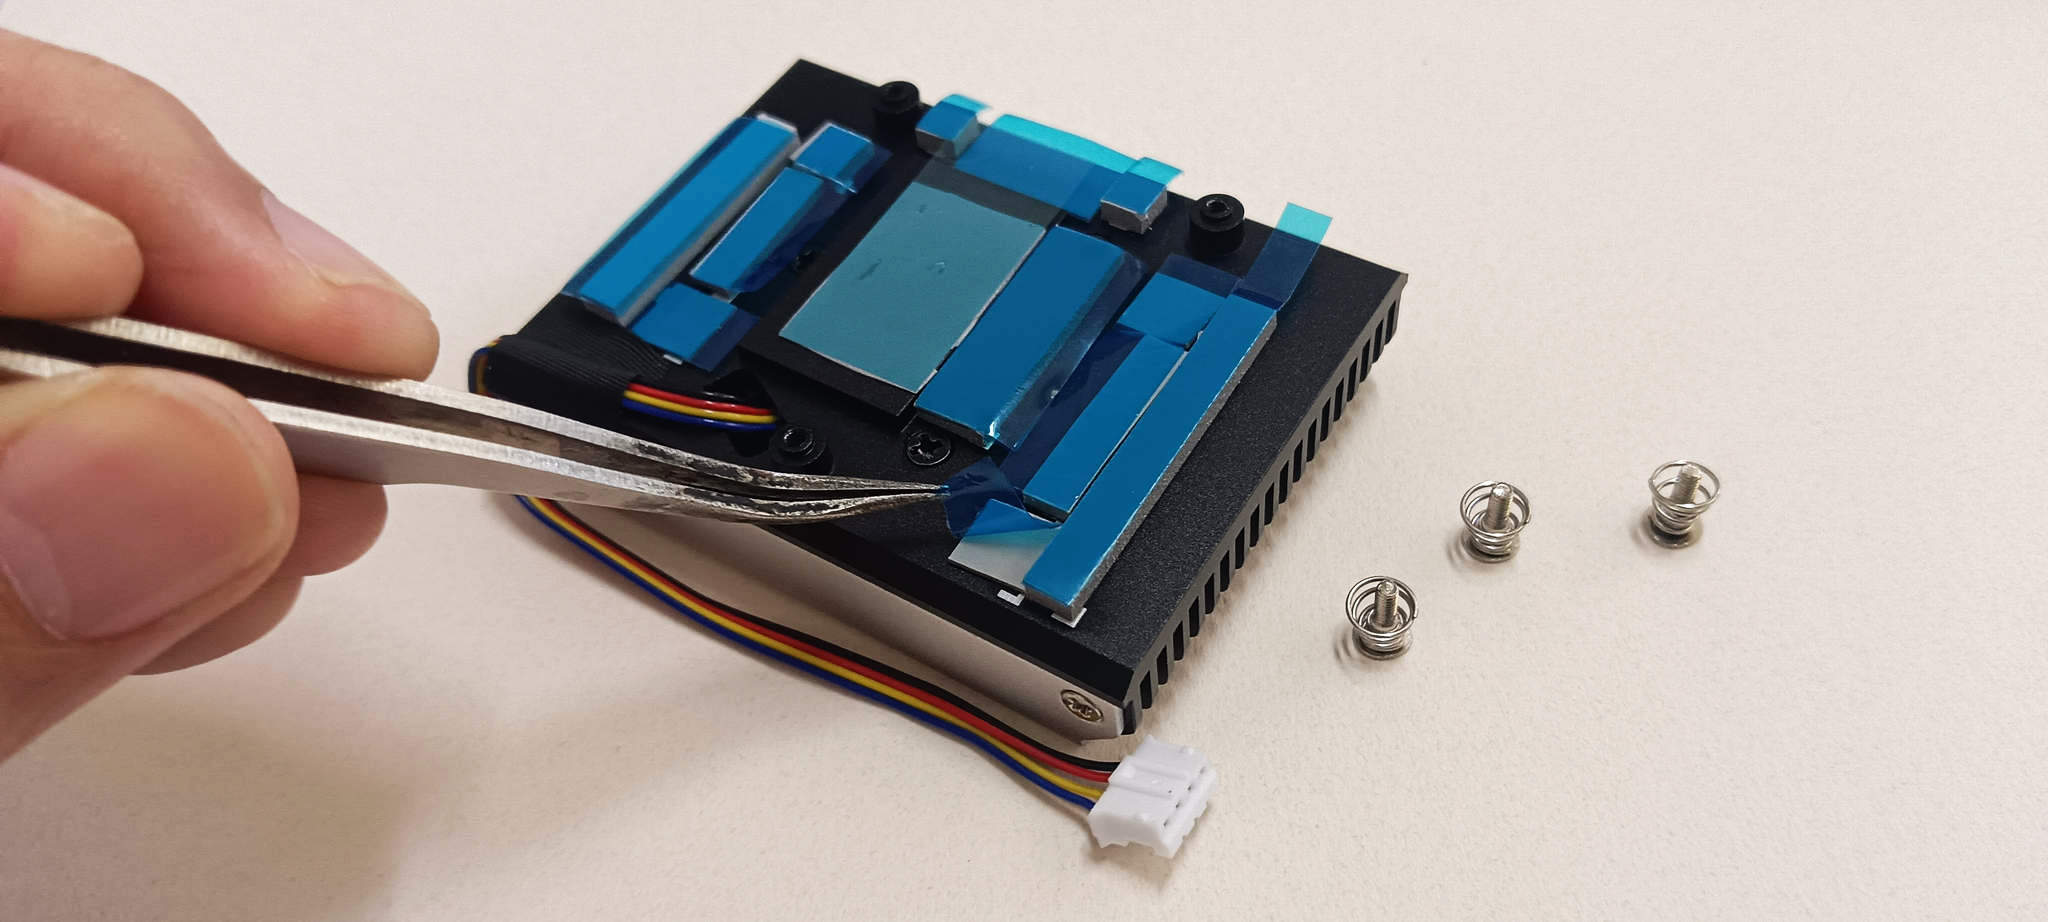
Подготовьте Aluminum Active Cooler.
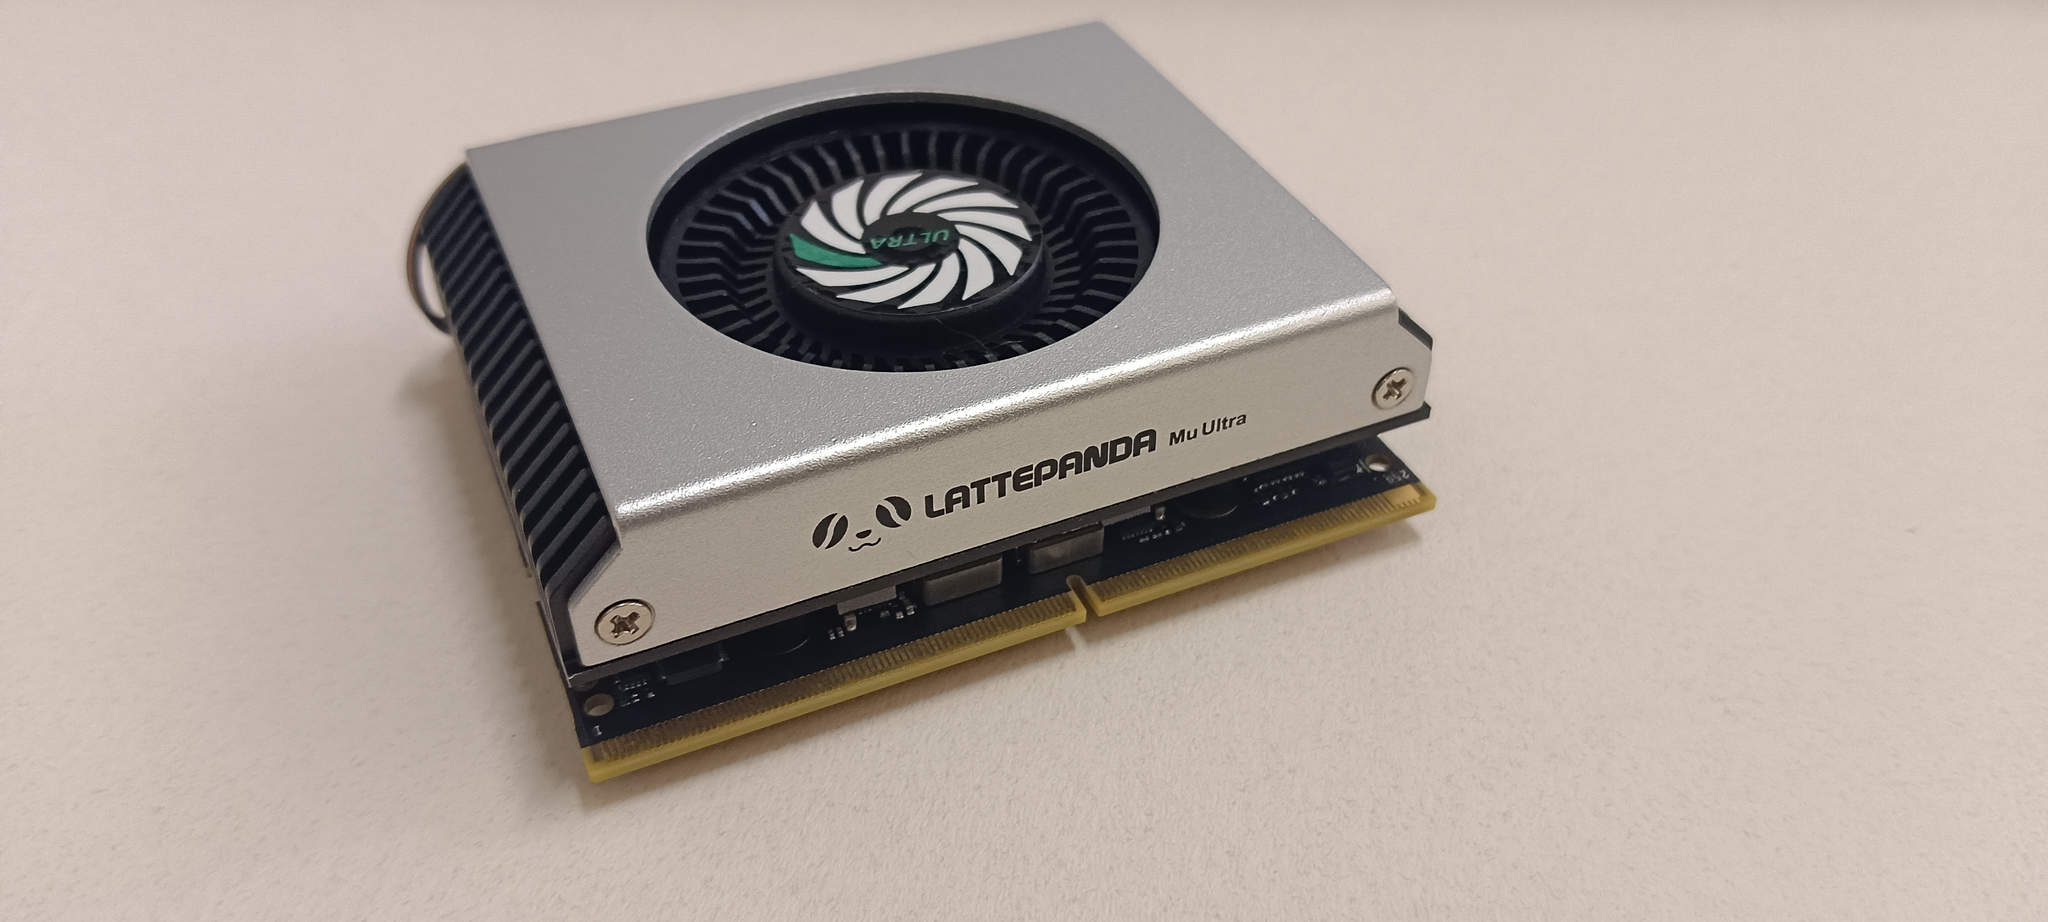
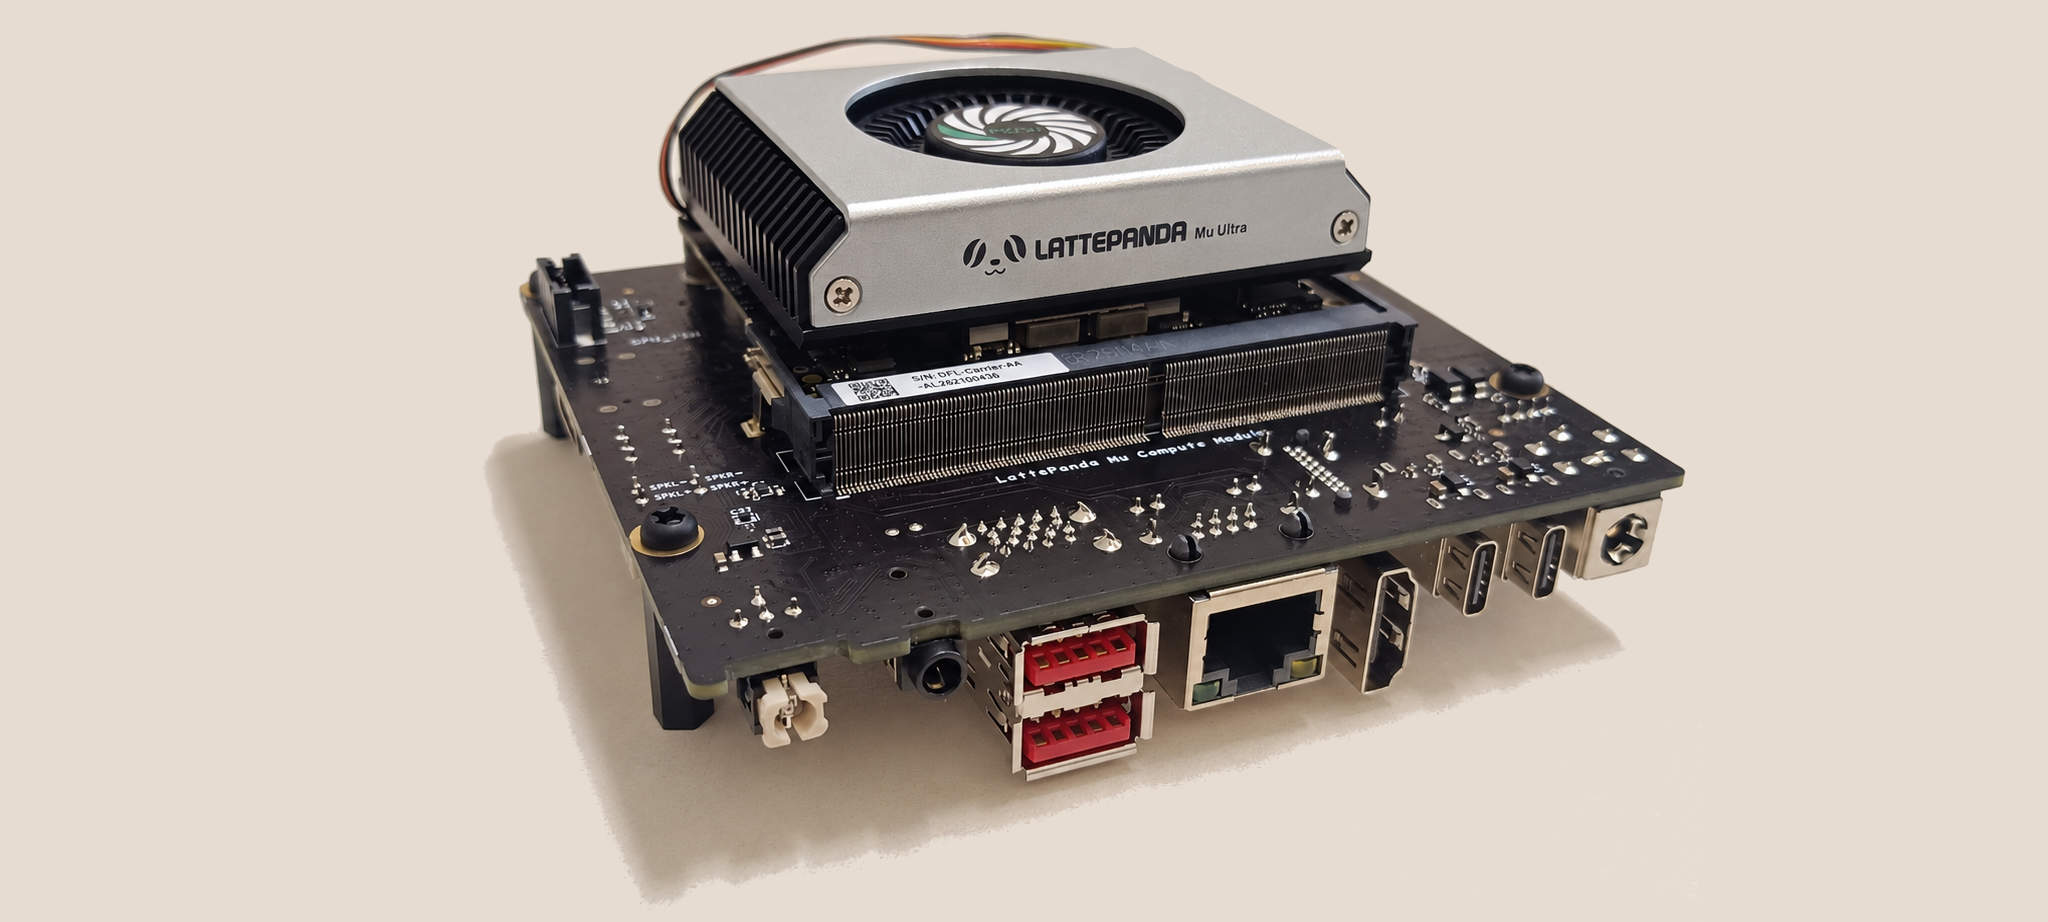
Установка операционной системы (Ubuntu 26.04)
Производитель предоставляет образ восстановления Windows 11 с предустановленными драйверами . В качестве альтернативы пользователи могут выполнить чистую установку Windows и отдельно скачать необходимые драйверы.
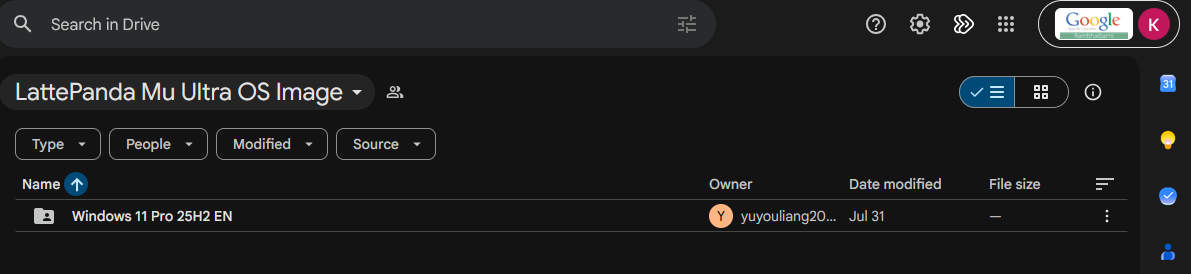
Официальный образ ОС Windows 11 Pro 25H2 (английская версия), предоставленный производителем.Однако для этого обзора была выбрана Linux. Руководство по установке от производителя рекомендует Ubuntu 24.04 LTS или более позднюю версию, поэтому была выбрана Ubuntu 26.04 LTS, а для создания установочного носителя использовался Rufus. Далее была выполнена стандартная процедура установки Ubuntu, которая прошла без каких-либо проблем.
ОС успешно установлена на модуль LattePanda Mu Ultra.Далее была проверена версия ядра Linux с помощью uname -r команда для проверки совместимости оборудования и драйверов на последующих этапах. Команда вывела 7.0.0-38-generic — версию ядра, которая использовалась на протяжении всего обзора.

Проверка текущей версии ядра Linux.
Установка драйверов для Linux
Следующим шагом стала установка драйверов GPU и NPU. Для драйвера GPU было использовано руководство по установке драйверов для GPU Intel и выбран метод установки пакетов из Ubuntu PPA .
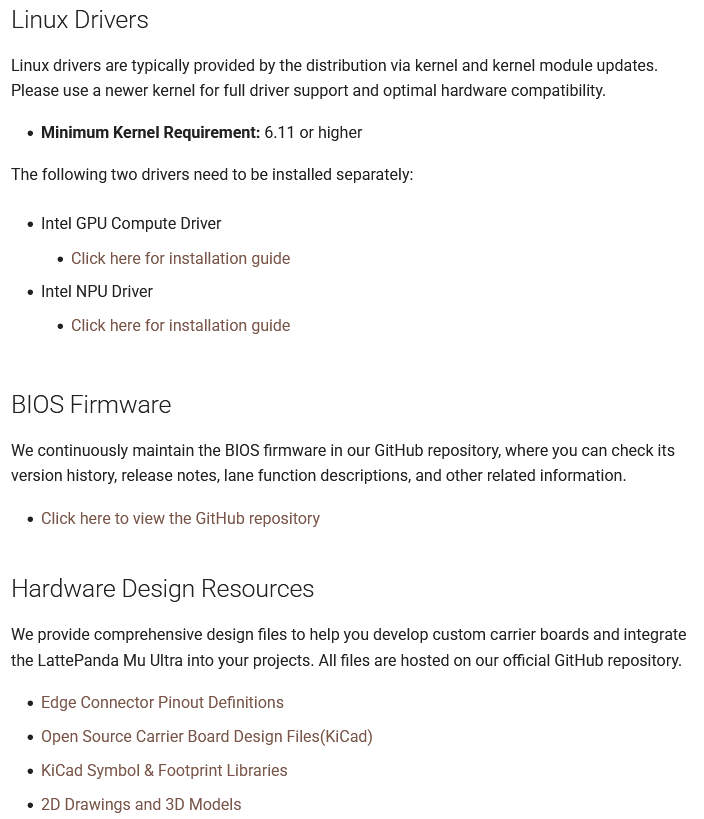
libtbb12, являющийся зависимостью intel-driver-compiler-npu. Далее были установлены остальные пакеты драйверов NPU, включая libze1 для поддержки Level Zero. Наконец, учетная запись пользователя была добавлена в группу render для предоставления доступа к устройствам GPU и NPU.
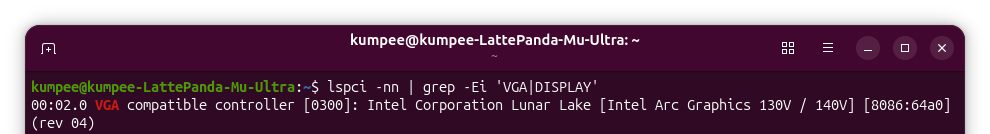
Далее было выполнено несколько команд для проверки того, может ли Linux корректно обнаруживать и использовать встроенный GPU. Результаты показали, что GPU Intel Arc Graphics (PCI ID 8086:64a0) распознан, доступны /dev/dri/card0 и /dev/dri/renderD128 . OpenCL также обнаружил GPU, что указывает на корректную работу графических и вычислительных драйверов, как показано на следующих изображениях.

Список доступных узлов устройств GPU.

Проверка информации об оборудовании с помощью inxi
Сначала плата LattePanda Mu Ultra была проверена с помощью команды inxi -Fc0 для изучения конфигурации оборудования и совместимости с Linux.
System:
  Host: kumpee-LattePanda-Mu-Ultra Kernel: 7.0.0-38-generic arch: x86_64
    bits: 64
  Desktop: GNOME v: 50.1 Distro: Ubuntu 26.04.1 LTS (Resolute Raccoon)
Machine:
  Type: Embedded-pc Mobo: LattePanda model: LattePanda Mu Ultra v: Standard
    serial: DF-X256V-#A-AL262300171 Firmware: UEFI vendor: LattePanda
    v: SBCLNLCXR120-A date: 04/30/2026
CPU:
  Info: 8-core model: Intel Core Ultra 7 256V bits: 64 type: MCP cache:
    L2: 14 MiB
  Speed (MHz): avg: 400 min/max: 400/4700:4800:3700 cores: 1: 400 2: 400
    3: 400 4: 400 5: 400 6: 400 7: 400 8: 400
Graphics:
  Device-1: Intel Lunar Lake [Intel Arc Graphics 130V / 140V] driver: xe
    v: kernel
  Display: unspecified server: X.Org v: 24.1.10 with: Xwayland v: 24.1.10
    driver: dri: iris gpu: xe resolution: 1920x1080~60Hz
  API: EGL v: 1.5 drivers: iris,swrast platforms: gbm,x11,surfaceless,device
  API: OpenGL v: 4.6 compat-v: 4.5 vendor: intel mesa v: 26.0.8-1ubuntu0.3
    renderer: Mesa Intel Graphics (LNL)
  Info: Tools: api: clinfo, eglinfo, glxinfo x11: xdriinfo, xdpyinfo,
    xprop, xrandr
Audio:
  Device-1: Intel Lunar Lake-M HD Audio driver: snd_hda_intel
  API: ALSA v: k7.0.0-38-generic status: kernel-api
Network:
  Device-1: Intel Ethernet I226-V driver: igc
  IF: enp2s0 state: up speed: 1000 Mbps duplex: full mac: 00:e0:4c:a2:c5:e3
Drives:
  Local Storage: total: 465.76 GiB used: 12.82 GiB (2.8%)
  ID-1: /dev/nvme0n1 vendor: Western Digital model: WD Blue SN5000 500GB
    size: 465.76 GiB
Partition:
  ID-1: / size: 456.35 GiB used: 12.82 GiB (2.8%) fs: ext4 dev: /dev/nvme0n1p2
  ID-2: /boot/efi size: 1.05 GiB used: 6.3 MiB (0.6%) fs: vfat
    dev: /dev/nvme0n1p1
Swap:
  ID-1: swap-1 type: file size: 4 GiB used: 0 KiB (0.0%) file: /swap.img
Sensors:
  System Temperatures: cpu: 27.8 C mobo: N/A
  Fan Speeds (rpm): N/A
Info:
  Memory: total: 16 GiB note: est. available: 14.8 GiB used: 4.56 GiB (30.8%)
  Processes: 383 Uptime: 10m Shell: Sudo inxi: 3.3.40
Плата работала под управлением Ubuntu 26.04.1 LTS (Resolute Raccoon) с ядром Linux 7.0.0-38 и GNOME 50.1. Система корректно распознала процессор Intel Core Ultra 7 256V с 8 ядрами CPU и максимальной тактовой частотой до 4,8 ГГц, а также 16 ГБ оперативной памяти. Материнская плата и прошивка UEFI также были корректно определены как оборудование LattePanda Mu Ultra.
Что касается графики, интегрированный графический процессор Intel Arc (архитектура Lunar Lake) был обнаружен и работал с использованием драйвера ядра xe для Linux и Mesa 26.0.8. Система сообщила о поддержке OpenGL 4.6 с разрешением дисплея 1920 × 1080 при 60 Гц. К другому обнаруженному оборудованию относились контроллер Ethernet Intel I226-V 2,5 Гбит/с, подключенный на скорости 1 Гбит/с к коммутатору, и аудиоконтроллер Intel HD Audio. Для хранения установлен SSD WD Blue SN5000 NVMe объемом 500 ГБ, обеспечивающий примерно 465,76 ГиБ полезной емкости.
В целом первоначальные inxi результаты показывают, что Ubuntu 26.04.1 LTS успешно распознает основные аппаратные компоненты LattePanda Mu Ultra, включая процессор, интегрированный графический процессор, Ethernet, аудио и NVMe-накопитель. Указанная температура процессора в режиме простоя составила примерно 27,8 °C во время первоначальной проверки, хотя это было лишь показание в режиме простоя, а не результат стресс-теста.
Тесты производительности LattePanda Mu Ultra
sbc-bench
Далее было проведено тестирование LattePanda Mu Ultra с использованием инструмента sbc-bench Томаса Кайзера , который оценивает производительность процессора, пропускную способность памяти и тепловое поведение при продолжительных нагрузках. Тест успешно определил гибридную архитектуру Intel Core Ultra 7 256V, состоящую из четырех производительных ядер Lion Cove (P-cores) и четырех энергоэффективных ядер Skymont (E-cores). В начальных условиях ядра P-cores достигали примерно 4,69 ГГц, а ядра E-cores — 3,69 ГГц, что близко к заявленным максимальным частотам.
Системная информация:
sbc-bench v0.9.72 LattePanda LattePanda Mu Ultra Standard / Ultra 7 256V (Tue, 20 Oct 2026 09:03:22 +0700)

Distributor ID:	Ubuntu
Description:	Ubuntu 26.04.1 LTS
Release:	26.04
Codename:	resolute

Device Info:
	Manufacturer: LattePanda
	Product Name: LattePanda Mu Ultra
	Version: Standard
	SKU Number: LattePanda Mu Ultra
	Family: LattePanda Compute Module

BIOS/UEFI:
	Vendor: LattePanda
	Version: SBCLNLCXR120-A
	Release Date: 04/30/2026
	BIOS Revision: 5.32

/usr/bin/gcc (Ubuntu 15.2.0-16ubuntu1) 15.2.0

Uptime: 09:03:22 up 2 min,  1 user,  load average: 0.33, 0.27, 0.10,  57.0°C,  29135556

Linux 7.0.0-38-generic (kumpee-LattePanda-Mu-Ultra) 	10/20/26 	_x86_64_	(8 CPU)

avg-cpu:  %user   %nice %system %iowait  %steal   %idle
           2.88    0.10    2.25    0.33    0.00   94.44

Device             tps    kB_read/s    kB_wrtn/s    kB_dscd/s    kB_read    kB_wrtn    kB_dscd
nvme0n1         268.28      8857.44       740.27         0.00    1160679      97005          0

               total        used        free      shared  buff/cache   available
Mem:            14Gi       1.5Gi        13Gi        88Mi       469Mi        13Gi
Swap:          4.0Gi          0B       4.0Gi

Filename				Type		Size		Used		Priority
/swap.img                               file		4194300		0		-1

##########################################################################

Intel P-States: Intel P-state driver initializing, HWP enabled

Intel Hardware Feedback Interface enabled (2 core types)

Powercap present. You might want to check with "powercap-info -p intel-rapl"

Checking cpufreq OPP for cpu0-cpu3 (Lion Cove):

Cpufreq OPP: 4700    Measured: 4685 (4685.871/4685.542/4685.542)
Cpufreq OPP:  400    Measured:  395    (395.819/395.795/395.702)     (-1.2%)

Checking cpufreq OPP for cpu4-cpu7 (Skymont):

Cpufreq OPP: 3700    Measured: 3687 (3687.656/3687.613/3687.571)
Cpufreq OPP:  400    Measured:  398    (399.868/398.560/396.703)

##########################################################################

Hardware sensors:

coretemp-isa-0000
Package id 0:  +50.0 C  (high = +100.0 C, crit = +100.0 C)
Core 0:        +48.0 C  (high = +100.0 C, crit = +100.0 C)
Core 4:        +45.0 C  (high = +100.0 C, crit = +100.0 C)
Core 8:        +46.0 C  (high = +100.0 C, crit = +100.0 C)
Core 12:       +46.0 C  (high = +100.0 C, crit = +100.0 C)
Core 32:       +45.0 C  (high = +100.0 C, crit = +100.0 C)
Core 33:       +45.0 C  (high = +100.0 C, crit = +100.0 C)
Core 34:       +45.0 C  (high = +100.0 C, crit = +100.0 C)
Core 35:       +45.0 C  (high = +100.0 C, crit = +100.0 C)

acpitz_0-acpi-0
temp1:        +27.8 C

nvme-pci-0100
Composite:    +37.9 C  (low  = -40.1 C, high = +83.8 C)
                       (crit = +87.8 C)
Sensor 1:     +57.9 C  (low  = -273.1 C, high = +65261.8 C)
Sensor 2:     +31.9 C  (low  = -273.1 C, high = +65261.8 C)

/dev/nvme0:	38°C

...
Тесты памяти показали хорошую производительность: P-core достигло примерно 24,3 ГБ/с в тесте memcpy по сравнению с 15,3 ГБ/с на E-core. Что касается производительности CPU, sbc-bench использует тест сжатия и распаковки 7-Zip для измерения возможностей как одно-, так и многопоточной обработки. В однопоточном тестировании P-core набрало общий балл 4 670 MIPS, тогда как E-core — 4 257 MIPS. При одновременной работе всех восьми ядер CPU многопоточный тест дал результаты 22 464, 19 894 и 19 936 MIPS в трёх последовательных прогонах, в среднем примерно 20 760 MIPS.
* cpu0 (Lion Cove): memcpy: 24269.5 MB/s, memchr: 29996.9 MB/s, memset: 95368.2 MB/s
  * cpu4 (Skymont): memcpy: 15307.0 MB/s, memchr: 24473.3 MB/s, memset: 23589.8 MB/s
  * cpu0 (Lion Cove) 16M latency: 31.68 26.24 32.37 26.49 31.51 28.43 29.62 40.94
  * cpu4 (Skymont) 16M latency: 133.9 78.47 97.07 87.15 96.37 66.20 52.67 52.36
  * cpu0 (Lion Cove) 128M latency: 131.1 124.0 130.3 122.9 130.8 119.5 102.0 91.82
  * cpu4 (Skymont) 128M latency: 127.4 136.7 139.8 137.5 134.9 122.1 115.5 109.7
  * 7-zip MIPS (3 consecutive runs): 22464, 19894, 19936 (20760 avg), single-threaded: 4670
  * `aes-256-cbc    1068105.16k  1321878.95k  1420131.84k  1466167.30k  1483849.73k  1261436.93k (Lion Cove)`
  * `aes-256-cbc    1127751.79k  1282259.52k  1325331.03k  1336898.56k  1340235.78k  1338862.25k (Skymont)`
Температурные показатели стали одним из наиболее интересных результатов. Во время интенсивного тестирования температура корпуса CPU часто достигала 95–96 °C, и система демонстрировала явные признаки теплового троттлинга. При продолжительной полной нагрузке на CPU частота P-core снижалась с примерно 4,7 ГГц до около 2,1–2,2 ГГц, что указывает на существенное снижение относительно начальной частоты Boost.
...
##########################################################################
Testing maximum cpufreq again, still under full load. System health now:

Time       big.LITTLE   load %cpu %sys %usr %nice %io %irq   Temp
09:16:41: 2100/1880MHz  8.03 100%   0%  99%   0%   0%   0%  96.0°C

Checking cpufreq OPP for cpu0-cpu3 (Lion Cove):

Cpufreq OPP: 2200    Measured: 2191 (2191.205/2191.156/2191.132)

Checking cpufreq OPP for cpu4-cpu7 (Skymont):

Cpufreq OPP: 3700    Measured: 3687 (3688.081/3687.826/3687.741)
##########################################################################
...
System health while running 7-zip single core benchmark:

Time       big.LITTLE   load %cpu %sys %usr %nice %io %irq   Temp
09:08:12: 3728/3701MHz  1.04  11%   0%  10%   0%   0%   0%  95.0°C
09:08:17: 3637/3664MHz  1.03  12%   0%  12%   0%   0%   0%  96.0°C
09:08:22: 3659/3687MHz  1.03  12%   0%  12%   0%   0%   0%  96.0°C
09:08:27: 3669/3413MHz  1.03  12%   0%  12%   0%   0%   0%  96.0°C
09:08:32: 3596/3702MHz  1.02  12%   0%  12%   0%   0%   0%  96.0°C
09:08:37: 3652/3700MHz  1.02  12%   0%  12%   0%   0%   0%  95.0°C
09:08:42: 3528/3702MHz  1.02  12%   0%  12%   0%   0%   0%  96.0°C
09:08:47: 4515/3701MHz  1.02  12%   0%  12%   0%   0%   0%  87.0°C
09:08:52:  400/3701MHz  1.02  12%   0%  12%   0%   0%   0%  85.0°C
09:08:57:  400/3701MHz  1.02  12%   0%  12%   0%   0%   0%  81.0°C
09:09:02:  709/3701MHz  1.01  12%   0%  12%   0%   0%   0%  82.0°C
09:09:07:  820/3701MHz  1.01  12%   0%  12%   0%   0%   0%  80.0°C
09:09:12:  402/3701MHz  1.01  12%   0%  12%   0%   0%   0%  79.0°C

System health while running 7-zip multi core benchmark:

Time       big.LITTLE   load %cpu %sys %usr %nice %io %irq   Temp
09:09:17: 3000/3401MHz  1.01  12%   0%  10%   0%   0%   0%  96.0°C
09:09:27: 1710/2400MHz  1.52  85%   0%  85%   0%   0%   0%  96.0°C
09:09:37: 2094/2672MHz  1.96  79%   0%  79%   0%   0%   0%  96.0°C
09:09:47:  455/3701MHz  2.89  90%   0%  89%   0%   0%   0%  96.0°C
09:09:59: 1911/2200MHz  3.60  83%   1%  82%   0%   0%   0%  96.0°C
09:10:11:  869/ 800MHz  4.20  84%   0%  84%   0%   0%   0%  95.0°C
09:10:23: 1986/2200MHz  5.11  92%   0%  92%   0%   0%   0%  96.0°C
09:10:35: 2147/1900MHz  5.04  76%   0%  75%   0%   0%   0%  96.0°C
09:10:47: 1888/2200MHz  5.58  74%   1%  73%   0%   0%   0%  96.0°C
09:10:59: 1865/2200MHz  6.19  82%   0%  82%   0%   0%   0%  96.0°C
09:11:11: 1895/2300MHz  5.91  79%   0%  79%   0%   0%   0%  96.0°C
09:11:23: 2060/2200MHz  6.13  77%   0%  77%   0%   0%   0%  96.0°C
09:11:34: 1352/2200MHz  5.86  73%   0%  73%   0%   0%   0%  96.0°C
09:11:44: 1900/1500MHz  6.19  96%   0%  95%   0%   0%   0%  95.0°C
...
Geekbench 7
Также была протестирована производительность CPU и GPU LattePanda Mu Ultra с помощью Geekbench 7.1.0. С опцией --gpu-list Geekbench успешно обнаружил встроенный GPU Intel Arc Graphics через OpenCL и Vulkan.
kumpee@kumpee-LattePanda-Mu-Ultra:~/Downloads/Geekbench-7.1.0$ ./geekbench7 --gpu-list
Geekbench 7.1.0 : https://www.geekbench.com/

...

OpenCL
+-------------+-----------+---------------------------+
| Platform ID | Device ID | Description               |
+-------------+-----------+---------------------------+
| 0           | 0         | Intel(R) Arc(TM) Graphics |
+-------------+-----------+---------------------------+

Vulkan
+-------------+-----------+----------------------------------+
| Platform ID | Device ID | Description                      |
+-------------+-----------+----------------------------------+
| 0           | 0         | Intel(R) Graphics (LNL)          |
+-------------+-----------+----------------------------------+
| 0           | 1         | llvmpipe (LLVM 21.1.8, 256 bits) |
+-------------+-----------+----------------------------------+
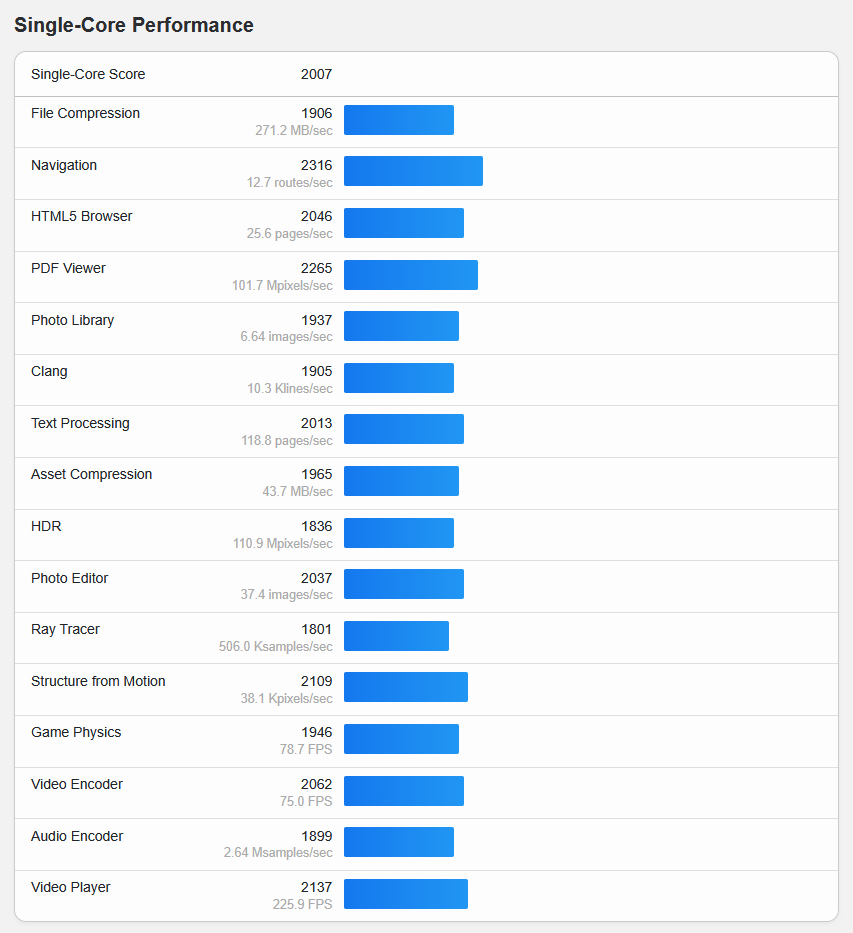
Что касается производительности CPU , LattePanda Mu Ultra показала результат 2 007 баллов в одноядерном тесте и 6 813 баллов в многоядерном. В одноядерных тестах процессор набрал 2 316 баллов в Navigation, 2 109 баллов в SfM и 2 062 балла в Video Encoding.
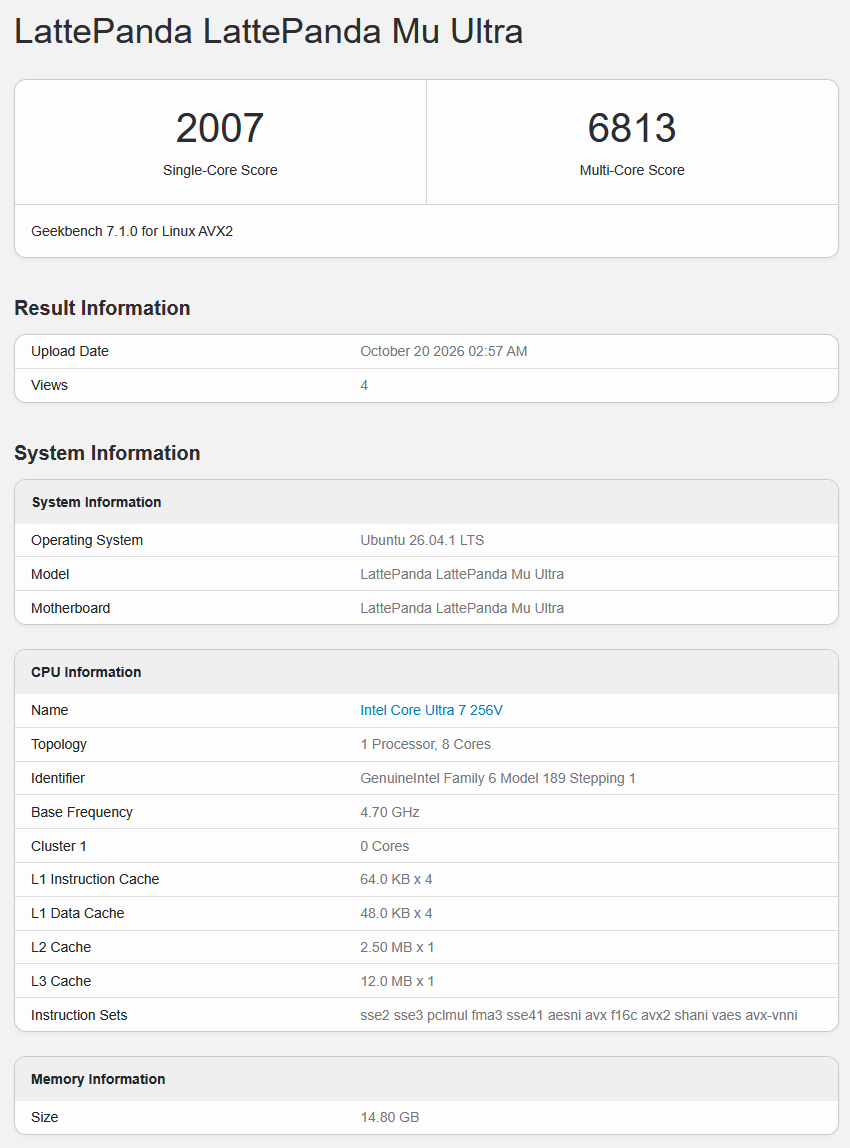
Общие результаты теста CPU Geekbench 7
Что касается многоядерной производительности, наивысшие результаты зафиксированы в Asset Compression (7 955 баллов), Text Processing (7 871 балл) и Photo Library (7 371 балл). Эти результаты демонстрируют возможности процессора как в вычислениях общего назначения, так и в параллельных нагрузках.
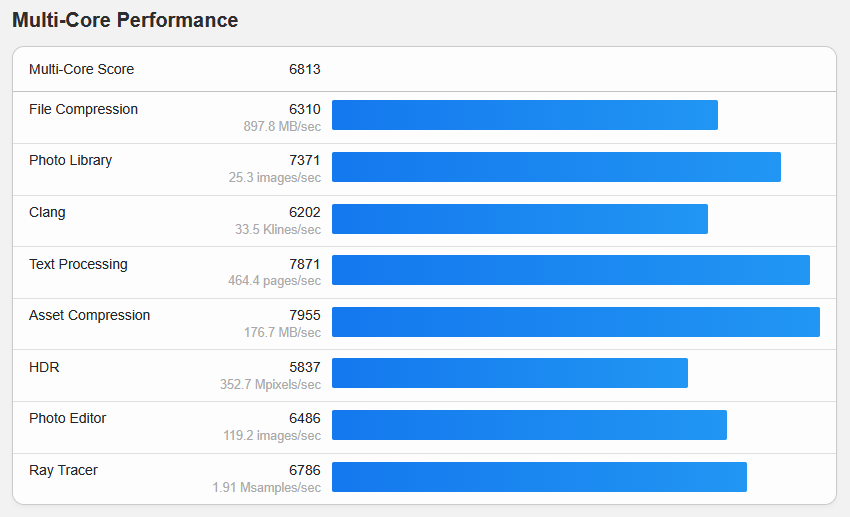
Результат теста CPU Geekbench 7: многоядерная производительность.Что касается производительности GPU , встроенная графика Intel Arc Graphics достигла результата OpenCL 24 963. Среди тестов Super Resolution показал наивысший результат 50 454 балла, затем Background Blur — 31 707 баллов, Face Tracking — 28 470 баллов и Feature Matching — 28 203 балла. Эти результаты подчёркивают потенциал встроенного GPU для обработки изображений, компьютерного зрения и приложений с GPU-ускорением.
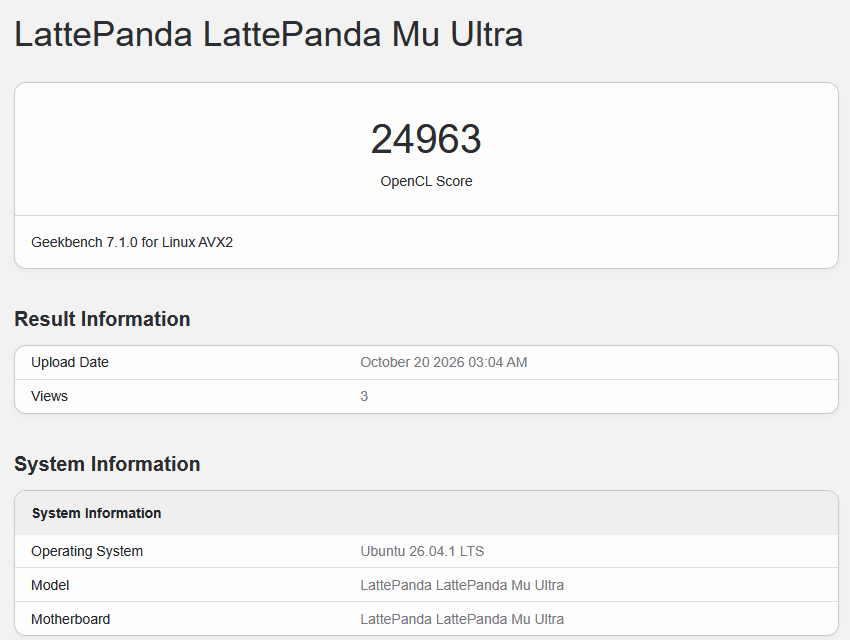
Общие результаты теста GPU Geekbench 7.
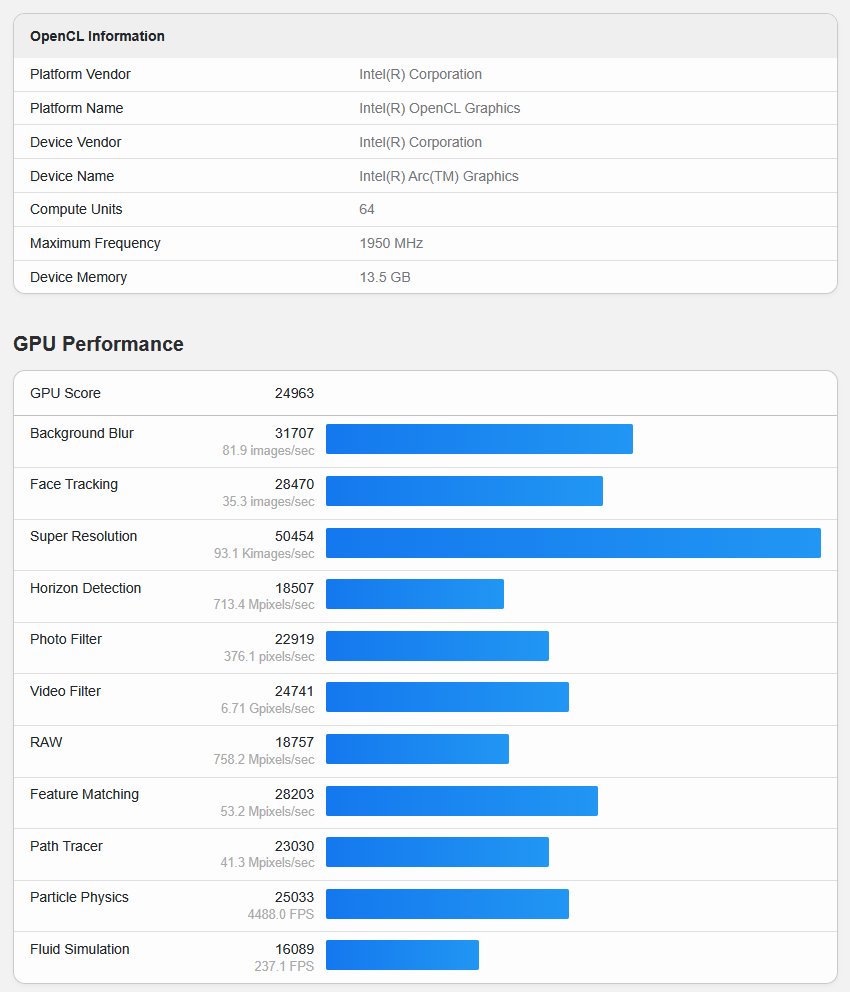
В целом результаты Geekbench 7 показывают, что LattePanda Mu Ultra обеспечивает уверенную производительность CPU и встроенного GPU с учётом компактных размеров, что делает её подходящей для мультимедиа, компьютерного зрения и приложений edge AI.
Тестирование производительности AI с помощью Geekbench AI
Для оценки возможностей AI-вычислений LattePanda Mu Ultra сначала был использован Geekbench AI 1.7.0 . Инструмент успешно обнаружил несколько фреймворков инференса, включая TensorFlow Lite, ONNX и Intel OpenVINO для тестирования CPU, а также OpenVINO для встроенного GPU Intel Arc.
kumpee@kumpee-LattePanda-Mu-Ultra:~/Downloads/GeekbenchAI-1.7.0$ ./banff --ai-list
Geekbench AI 1.7.0 : https://www.geekbench.com/ai/

Geekbench AI requires an active internet connection and automatically uploads
benchmark results to the Geekbench Browser.

+-----------------+----+---------+----+----------------------------------+----+
| Framework       | ID | Backend | ID | Device                           | ID |
+-----------------+----+---------+----+----------------------------------+----+
| TensorFlow Lite | 1  | CPU     | 1  | Intel Core Ultra 7 256V          | 0  |
+-----------------+----+---------+----+----------------------------------+----+
| ONNX            | 3  | CPU     | 1  | Intel Core Ultra 7 256V          | 0  |
+-----------------+----+---------+----+----------------------------------+----+
| OpenVINO        | 4  | CPU     | 1  | Intel(R) Core(TM) Ultra 7 256V   | 0  |
+-----------------+----+---------+----+----------------------------------+----+
| OpenVINO        | 4  | GPU     | 2  | Intel(R) Arc(TM) Graphics (iGPU) | 1  |
С использованием TensorFlow Lite CPU backend
С использованием TensorFlow Lite CPU backend , результат LattePanda Mu Ultra составил 1 133 балла в одинарной точности (SP), 1 086 баллов — в половинной точности (HP) и 756 баллов — в квантованном выводе (Q). В отдельных тестах классификация изображений достигла 189,9 IPS (SP), обнаружение объектов — 56,4 IPS (SP), сегментация изображений — 17,1 IPS (SP), а оценка глубины — 10,3 IPS (SP). Другие результаты: обнаружение лиц — 15,6 IPS (HP), оценка позы — 1,67 IPS (Q), суперразрешение изображений — 27,6 IPS (Q).
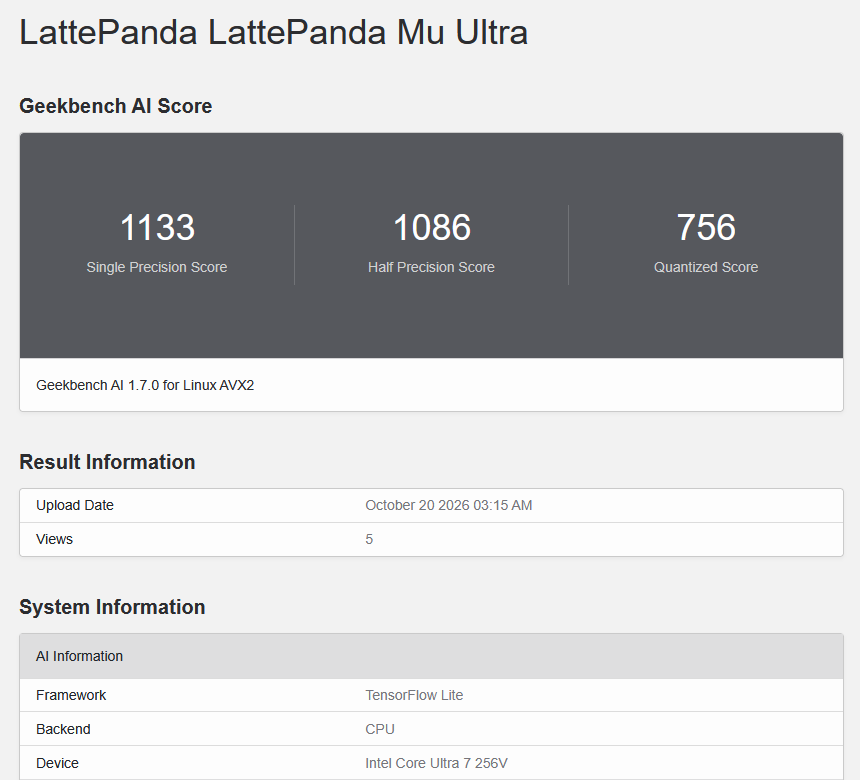
Результат теста Geekbench AI: TensorFlow CPU backend.
С использованием Intel OpenVINO CPU backend
С использованием Intel OpenVINO CPU backend , результат модуля составил 1 427 баллов в одинарной точности (SP), 1 006 баллов — в половинной точности (HP) и 3 922 балла — в квантованном выводе (Q). В отдельных тестах классификация изображений достигла 184,9 IPS (SP), обнаружение объектов — 58,9 IPS (SP), сегментация изображений — 17,6 IPS (SP), а оценка глубины — 14,4 IPS (SP). Другие результаты: обнаружение лиц — 22,4 IPS (HP), оценка позы — 5,98 IPS (Q), суперразрешение изображений — 122,0 IPS (Q).
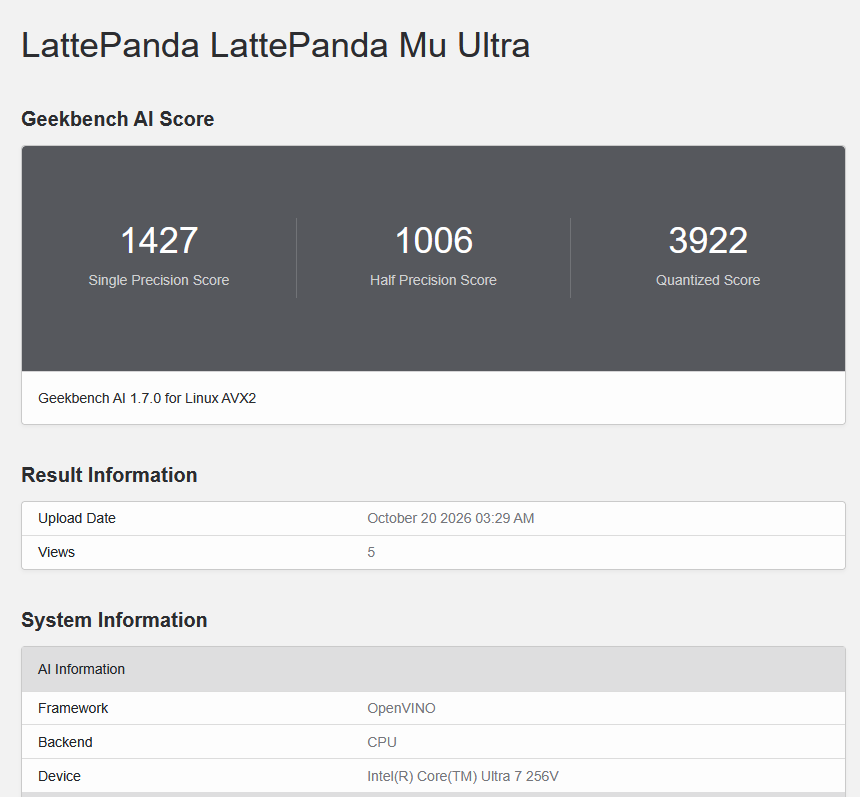
Результат теста Geekbench AI: OpenVINO CPU backend.
С использованием ONNX CPU backend
С использованием ONNX CPU backend , результат LattePanda Mu Ultra составил 1 563 балла в одинарной точности (SP), 449 баллов — в половинной точности (HP) и 3 747 баллов — в квантованном выводе (Q). В отдельных тестах классификация изображений достигла 219,0 IPS (SP), обнаружение объектов — 75,5 IPS (SP), сегментация изображений — 13,2 IPS (SP), а оценка глубины — 21,1 IPS (SP). Другие результаты: обнаружение лиц — 78,7 IPS (Q), оценка позы — 10,6 IPS (Q), суперразрешение изображений — 88,9 IPS (Q).
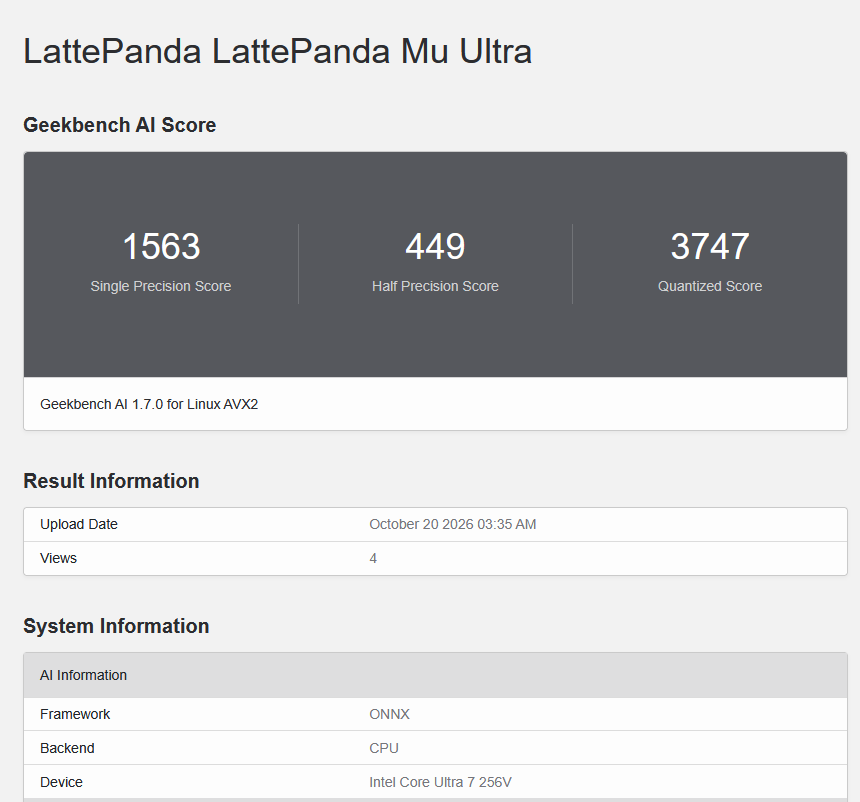
Результат теста Geekbench AI: ONNX CPU backend.
С бэкендом OpenVINO GPU: сбой
Также тестировался Geekbench AI 1.7.0 с бэкендом OpenVINO GPU. Хотя встроенный GPU Intel Arc был успешно обнаружен, тест завершился сбоем во время первого теста классификации изображений с ошибкой OpenCL CL_OUT_OF_RESOURCES. Это может быть связано с проблемами совместимости между Geekbench AI, OpenVINO и установленными драйверами GPU, поскольку другие приложения с ускорением на GPU работали без проблем.
AI Information
  Framework                     OpenVINO
  Backend                       GPU
  Device                        Intel(R) Arc(TM) Graphics (iGPU)

System Information
  Operating System              Ubuntu 26.04.1 LTS
  Model                         LattePanda LattePanda Mu Ultra
  Motherboard                   LattePanda LattePanda Mu Ultra
  BIOS                          LattePanda SBCLNLCXR120-A

CPU Information
  Name                          Intel Core Ultra 7 256V
  Topology                      1 Processor, 8 Cores
  Identifier                    GenuineIntel Family 6 Model 189 Stepping 1
  Base Frequency                4.70 GHz

Memory Information
  Size                          14.8 GB

  Running Image Classification (SP)
Geekbench AI encountered an internal error. Contact support@primatelabs.com for help.

Internal error message: Exception from src/inference/src/cpp/infer_request.cpp:224:
Exception from src/plugins/intel_gpu/src/runtime/ocl/ocl_stream.cpp:376:
[GPU] clFinish, error code: -5 CL_OUT_OF_RESOURCES
В любом случае решено пропустить неудачный тест и перейти к другим тестам, поскольку в следующих разделах также планировалось тестировать CPU, GPU и NPU с помощью таких инструментов, как llama.cpp и YOLO26. Подводя итог результатам Geekbench AI: ONNX показал лучший результат в одинарной точности, а TensorFlow Lite имел небольшое преимущество в половинной точности. OpenVINO особенно хорошо показал себя с квантованными моделями, при этом ONNX ненамного отстал. В целом OpenVINO и ONNX дали лучшие результаты в большинстве тестов, что показывает, насколько выбор бэкенда вывода может влиять на производительность ИИ даже на одном и том же оборудовании. Хотя GPU был обнаружен, как минимум один тест с OpenVINO завершился сбоем, а NPU вообще не был обнаружен. Это примерно совпадает с тем, что наблюдалось при использовании Geekbench AI в обзоре мини-ПК GEEKOM IT13 Max (Intel Core Ultra 9 185G) с Ubuntu 26.04 .
Воспроизведение видео YouTube
Далее была протестирована производительность воспроизведения видео YouTube на LattePanda Mu Ultra путем воспроизведения видео в разных разрешениях — от 144p до 2160p (4K). Для контроля производительности воспроизведения, включая пропущенные кадры, использовалась функция YouTube «Статистика для знатоков». В целом воспроизведение было плавным во всех протестированных разрешениях. На следующем изображении показаны результаты для видео, воспроизводимых в разрешениях от 144p до 480p.
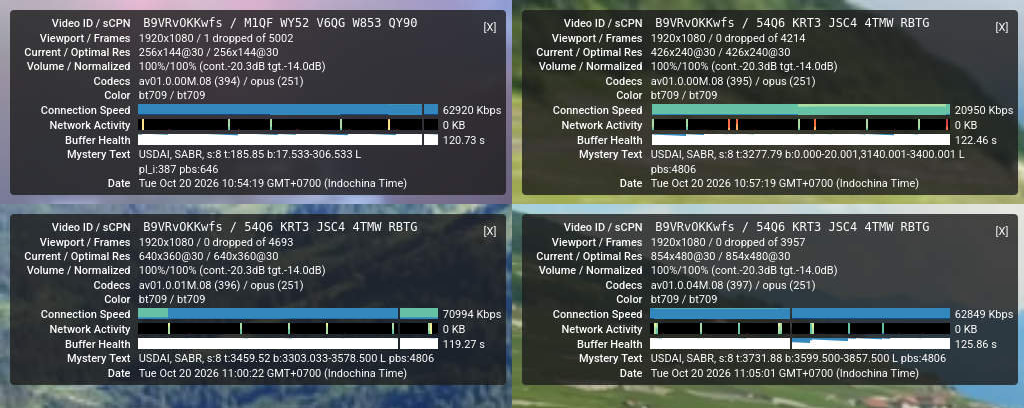
Производительность воспроизведения видео YouTube: (сверху слева) 144p, (сверху справа) 240p, (снизу слева) 360p и (снизу справа) 480p.
На следующем изображении показана производительность воспроизведения в разрешениях от 720p до 2160p (4K). Воспроизведение оставалось плавным во всех протестированных разрешениях.
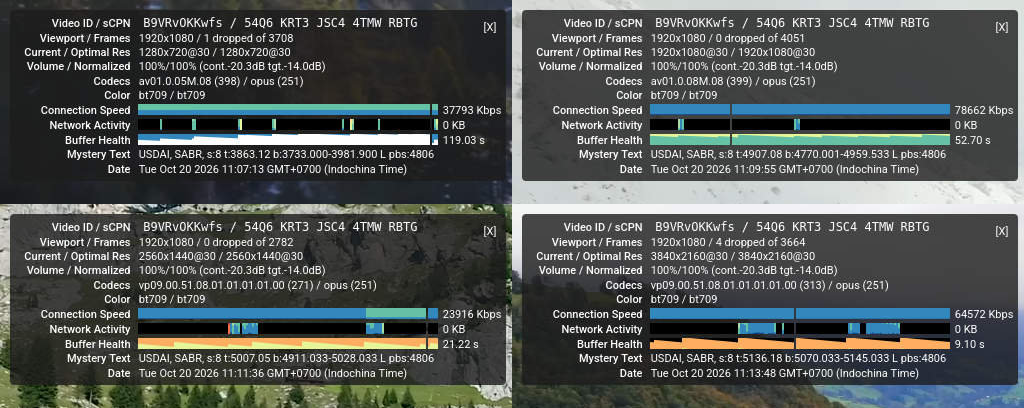
Производительность воспроизведения видео YouTube: (сверху слева) 720p, (сверху справа) 1080p, (снизу слева) 1440p и (снизу справа) 2160p.Предыдущие тесты выполнялись при разрешении монитора Full HD (1920 × 1080). Затем разрешение дисплея было изменено на 4K (3840 × 2160), и тест воспроизведения YouTube был повторен, как показано на следующем изображении. В целом воспроизведение в 4K оставалось плавным, с лишь несколькими пропущенными кадрами.
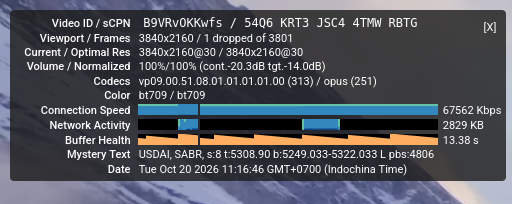
Производительность воспроизведения YouTube в 4K при разрешении дисплея 4K.В целом эти результаты показывают, что LattePanda Mu Ultra хорошо справляется с воспроизведением видео YouTube в высоком разрешении, включая видео 4K, закодированные современными кодеками.
Производительность просмотра веб-страниц с использованием Speedometer 3.1
Также была протестирована производительность просмотра веб-страниц на LattePanda Mu Ultra с использованием Speedometer 3.1 в Google Chrome. Устройство LattePanda Mu Ultra достигло общего результата 19,7 ± 1,4. При рассмотрении отдельных тестов модуль выполнил тест TodoMVC на основе React в среднем за 49,4 мс, Vue — за 31,6 мс, Svelte — за 22,6 мс. Для более сложных веб-приложений тест новостного сайта на Next.js занял около 142,8 мс, а версия на Nuxt завершилась за 119,5 мс. Среди других результатов — 30,7 мс для редактора CodeMirror, 51,8 мс для Chart.js и 72,0 мс для теста панели мониторинга производительности.
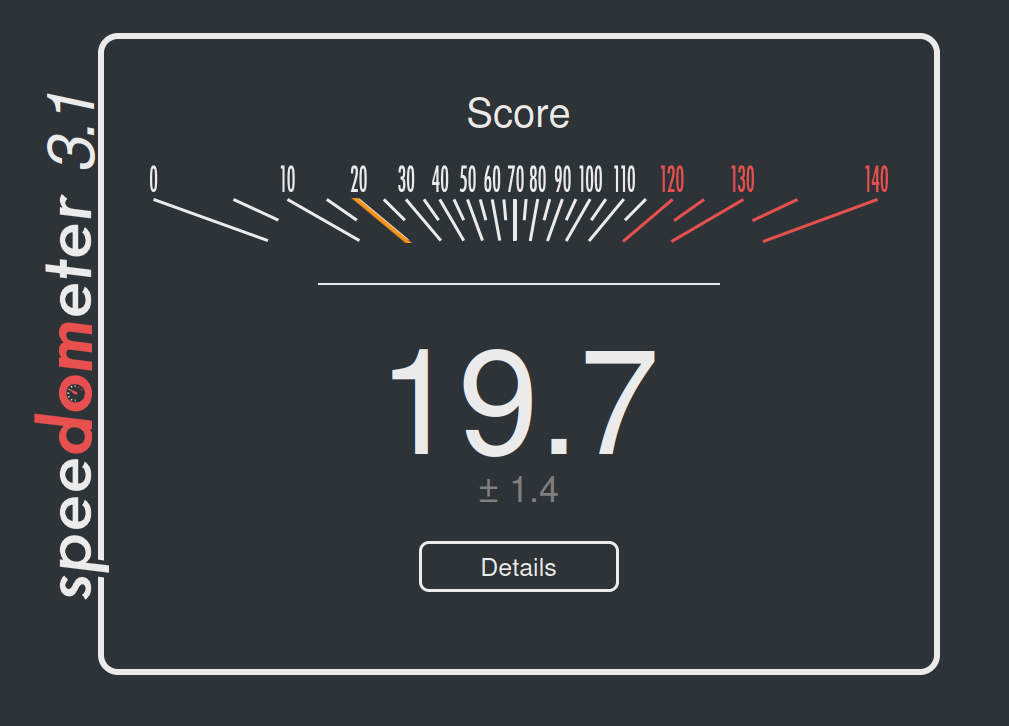
Результат теста Speedometer 3.1 в Google Chrome.
Тестирование производительности CPU, GPU и NPU с использованием llama.cpp
Проверены возможности системы в работе с Vulkan с помощью команды vulkaninfo . Результаты подтвердили, что встроенный GPU Intel обнаружен, поддерживается Vulkan 1.4 через драйвер Mesa 26.0.8, что указывает на готовность GPU к дальнейшему тестированию с llama.cpp.
...
Device Properties and Extensions:
=================================
GPU0:
VkPhysicalDeviceProperties:
---------------------------
	apiVersion        = 1.4.335 (4211023)
	driverVersion     = 26.0.8 (109051912)
	vendorID          = 0x8086
	deviceID          = 0x64a0
	deviceType        = PHYSICAL_DEVICE_TYPE_INTEGRATED_GPU
	deviceName        = Intel(R) Graphics (LNL)
...
VkPhysicalDeviceVulkan12Properties:
-----------------------------------
driverID      = DRIVER_ID_INTEL_OPEN_SOURCE_MESA
driverName    = Intel open-source Mesa driver
driverInfo    = Mesa 26.0.8-1ubuntu0.3
...
VkQueueFamilyProperties:
------------------------
queueFlags    = QUEUE_GRAPHICS_BIT |
                QUEUE_COMPUTE_BIT  |
                QUEUE_TRANSFER_BIT
Затем были установлены необходимые инструменты разработки и библиотеки, включая CMake, OpenBLAS и Vulkan, чтобы подготовить систему к компиляции и запуску llama.cpp. После установки этих пакетов проект llama.cpp был клонирован из официальный GitHub- репозиторий. Для тестирования производительности были выбраны две квантованные модели: Llama 3.2 3B Instruct (Q4_K_M) и Llama 3.1 8B Instruct (Q4_K_M), с размерами файлов приблизительно 1,87 GiB и 4,58 GiB соответственно. Сначала была скомпилирована CPU-версия llama.cpp; компиляция завершилась успешно без каких-либо проблем.
sudo apt install -y git cmake build-essential ninja-build libvulkan-dev vulkan-tools glslc libshaderc-dev Mesa-vulkan-drivers
git clone https://github.com/ggml-org/llama.cpp.git
cd llama.cpp
cmake -B build-cpu \
    -DGGML_VULKAN=OFF \
    -DGGML_CUDA=OFF \
    -DGGML_BLAS=OFF \
    -DGGML_NATIVE=ON \
    -DCMAKE_BUILD_TYPE=Release
Далее тесты производительности выполнены с использованием восьми потоков CPU, 512 входных токенов, 128 сгенерированных токенов и пяти повторов для каждой модели. Модель 3B показала 48,08 токенов/с при обработке промпта и 13,59 токенов/с при генерации текста.
kumpee@kumpee-LattePanda-Mu-Ultra:~/Documents/llama-bench/llama.cpp$ ./build-cpu/bin/llama-bench -m ../models/Llama-3.2-3B-Instruct-Q4_K_M.gguf -ngl 0 -p 512 -t 8 -n 128 -r 5
| model                          |       size |     params | backend    | threads |            test |                  t/s |
| ------------------------------ | ---------: | ---------: | ---------- | ------: | --------------: | -------------------: |
| llama 3B Q4_K - Medium         |   1.87 GiB |     3.21 B | CPU        |       8 |           pp512 |         48.08 ± 2.34 |
| llama 3B Q4_K - Medium         |   1.87 GiB |     3.21 B | CPU        |       8 |           tg128 |         13.59 ± 0.97 |

build: 1d88cb05f (11749)
Далее llama.cpp скомпилирован с поддержкой Vulkan для использования встроенного GPU Intel Arc. Сборка завершилась успешно, и GPU был корректно обнаружен бэкендом Vulkan. GPU показал 854,51 токенов/с при обработке промпта и 14,14 токенов/с при генерации текста. По сравнению с CPU обработка промпта стала приблизительно в 17,8 раза быстрее, тогда как генерация текста улучшилась только примерно на 4%.
kumpee@kumpee-LattePanda-Mu-Ultra:~/Documents/llama-bench/llama.cpp$ ./build-vulkan/bin/llama-bench -m ../models/Llama-3.2-3B-Instruct-Q4_K_M.gguf -ngl 99 -p 512 -n 128 -r 5
ggml_vulkan: Found 1 Vulkan devices:
ggml_vulkan: 0 = Intel(R) Graphics (LNL) (Intel open-source Mesa driver) | uma: 1 | fp16: 1 | bf16: 1 | fp4: 0 | warp size: 32 | shared memory: 49152 | int dot: 1 | matrix cores: KHR_coopmat
| model                          |       size |     params | backend    | ngl |            test |                  t/s |
| ------------------------------ | ---------: | ---------: | ---------- | --: | --------------: | -------------------: |
| llama 3B Q4_K - Medium         |   1.87 GiB |     3.21 B | Vulkan     |  99 |           pp512 |        854.51 ± 6.47 |
| llama 3B Q4_K - Medium         |   1.87 GiB |     3.21 B | Vulkan     |  99 |           tg128 |         14.14 ± 0.78 |

build: 1d88cb05f (11749)
Затем тест производительности CPU был повторён с использованием более крупной модели Llama 3.1 8B Instruct при сохранении тех же параметров тестирования для сопоставимого сравнения. CPU показал 19,40 токена/с при обработке промпта и 6,16 токена/с при генерации текста. Как и ожидалось, производительность снизилась при использовании более крупной модели, особенно при последовательной генерации токенов.
kumpee@kumpee-LattePanda-Mu-Ultra:~/Documents/llama-bench/llama.cpp$ ./build-cpu/bin/llama-bench -m ../models/Meta-Llama-3.1-8B-Instruct-Q4_K_M.gguf -ngl 0 -t 8 -p 512 -n 128 -r 5
| model                          |       size |     params | backend    | threads |            test |                  t/s |
| ------------------------------ | ---------: | ---------: | ---------- | ------: | --------------: | -------------------: |
| llama 8B Q4_K - Medium         |   4.58 GiB |     8.03 B | CPU        |       8 |           pp512 |         19.40 ± 0.42 |
| llama 8B Q4_K - Medium         |   4.58 GiB |     8.03 B | CPU        |       8 |           tg128 |          6.16 ± 0.30 |

build: 1d88cb05f (11749)
Наконец, модель 8B была протестирована с использованием бэкенда Vulkan при включённой выгрузке вычислений на GPU. GPU показал 303,38 токена/с при обработке промпта и 6,44 токена/с при генерации текста. Это означает примерно в 15,6 раза более быструю обработку промпта по сравнению с CPU, тогда как генерация текста улучшилась лишь примерно на 4,5%.
kumpee@kumpee-LattePanda-Mu-Ultra:~/Documents/llama-bench/llama.cpp$ ./build-vulkan/bin/llama-bench -m ../models/Meta-Llama-3.1-8B-Instruct-Q4_K_M.gguf -ngl 99 -p 512 -n 128 -r 5
ggml_vulkan: Found 1 Vulkan devices:
ggml_vulkan: 0 = Intel(R) Graphics (LNL) (Intel open-source Mesa driver) | uma: 1 | fp16: 1 | bf16: 1 | fp4: 0 | warp size: 32 | shared memory: 49152 | int dot: 1 | matrix cores: KHR_coopmat
| model                          |       size |     params | backend    | ngl |            test |                  t/s |
| ------------------------------ | ---------: | ---------: | ---------- | --: | --------------: | -------------------: |
| llama 8B Q4_K - Medium         |   4.58 GiB |     8.03 B | Vulkan     |  99 |           pp512 |        303.38 ± 4.57 |
| llama 8B Q4_K - Medium         |   4.58 GiB |     8.03 B | Vulkan     |  99 |           tg128 |          6.44 ± 0.35 |

build: 1d88cb05f (11749)
Следующие графики сравнивают производительность инференса CPU и GPU для обеих моделей Llama.
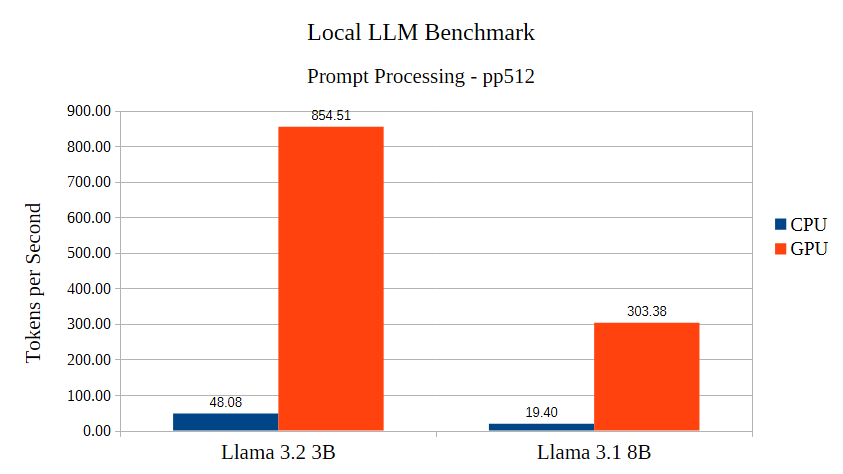
Производительность обработки промпта в llama.cpp (pp512).
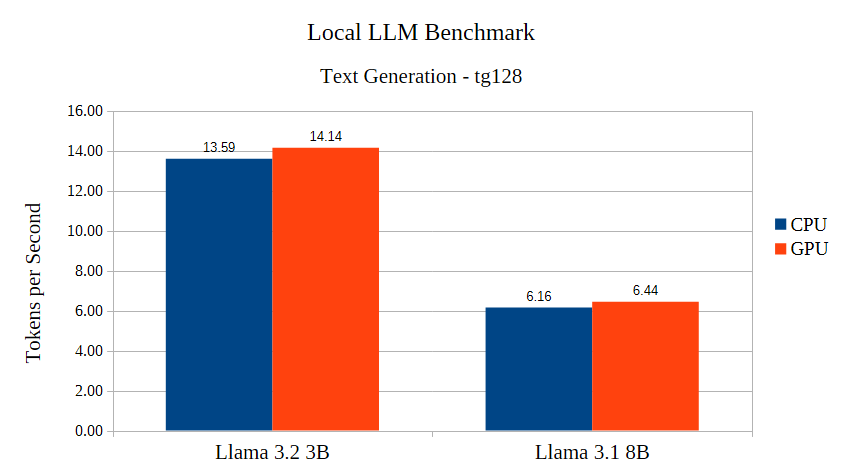
Результаты наглядно демонстрируют, что ускорение на GPU обеспечивает существенное преимущество при обработке промпта, особенно при обработке более длинных входных последовательностей. Однако производительность генерации текста остаётся относительно схожей между CPU и GPU в данных условиях тестирования, что указывает на то, что ускорение на GPU наиболее полезно на этапе обработки промпта, а не при последовательной генерации токенов.
Также была предпринята попытка настроить llama.cpp для использования Intel AI Boost NPU, однако настройка оказалась довольно сложной и требовала нескольких дополнительных зависимостей. Чтобы избежать внесения ненужных изменений в существующую системную среду, было решено перейти на Intel OpenVINO. Была создана новая виртуальная среда Python, установлены необходимые пакеты, и успешно обнаружены все три устройства: CPU, GPU и NPU.
python3 -m venv ~/openvino-env
source ~/openvino-env/bin/activate
pip install --upgrade pip
pip install openvino
sudo apt install -y \
    build-essential \
    cmake \
    ninja-build \
    libcurl4-openssl-dev \
    libtbb12 \
    ocl-icd-opencl-dev \
    opencl-headers \
    opencl-clhpp-headers \
    Intel-opencl-icd
python -m pip install \
    "optimum-intel[openvino]" \
    nncf \
    transformers
После установки для проверки того, может ли OpenVINO обнаруживать доступные вычислительные устройства, использовался простой скрипт Python, сгенерированный ChatGPT. Скрипт успешно выполнился и подтвердил, что все CPU, GPU и NPU были доступны из среды Python.
(openvino-env) kumpee@kumpee-LattePanda-Mu-Ultra:~/Documents$ python llama_openvino/test_openvino.py
Available OpenVINO devices:
CPU: Intel(R) Core(TM) Ultra 7 256V
GPU: Intel(R) Arc(TM) Graphics (iGPU)
NPU: Intel(R) AI Boost
Затем с помощью ChatGPT был подготовлен ещё один простой скрипт Python для тестирования производительности инференса LLM с использованием OpenVINO GenAI. Меньшая модель TinyLlama показала около 22–30 токенов/с при времени до первого токена (TTFT) 0,5–0,7 секунды.
(openvino-env) kumpee@kumpee-LattePanda-Mu-Ultra:~/Documents/llama_openvino$ python test_rum_llm_openvino.py
TTFT: 523.9 ms
TPOT: 44.7 ms/token
Throughput: 22.4 tokens/s
При этом более крупная модель Qwen2.5 7B была заметно медленнее, достигая около 5–8 токенов/с при TTFT примерно 4–7,6 секунды.
(openvino-env) kumpee@kumpee-LattePanda-Mu-Ultra:~/Documents/llama_openvino$ python test_rum_llm_openvino.py
TTFT: 4590.5 ms
TPOT: 155.7 ms/token
Throughput: 6.4 tokens/s
В целом тесты подтвердили, что LattePanda Mu Ultra может запускать локальные LLM с использованием CPU, встроенного GPU и NPU. GPU обеспечил существенное ускорение обработки промпта, а NPU успешно выполнял инференс LLM через OpenVINO.
YOLO26 на наборе для разработки LattePanda Mu Ultra
Производительность инференса YOLO26 только в прямом проходе
Для тестирования YOLO26 моделей с OpenVINO было создано отдельное виртуальное окружение Python.
python3 -m venv venv_yolo26
source venv_yolo26/bin/activate
python -m pip install --upgrade pip
python -m pip install opencv-python "openvino==2026.2.0" "ultralytics[export-openvino]" numpy
С помощью ChatGPT был подготовлен ещё один скрипт Python для тестирования производительности вывода YOLO26 с использованием OpenVINO. Были протестированы три модели (YOLO26n, YOLO26s и YOLO26m) на CPU, GPU и NPU. Каждая модель была экспортирована в формате FP16 с фиксированным входным разрешением 640 × 640 пикселей. В приведённом ниже коде показана ключевая функция тестирования производительности, используемая для измерения задержки вывода и расчёта эквивалентного FPS.
# Warm up the device before timing
for _ in range(warmup):
    request.infer()

# Measure inference latency
times_ms = np.empty(iterations, dtype=np.float64)

for i in range(iterations):
    start = time.perf_counter_ns()
    request.infer()
    times_ms[i] = (time.perf_counter_ns() - start) * 1e-6

# Calculate average latency and equivalent FPS
mean_ms = float(times_ms.mean())
equiv_fps = 1000.0 / mean_ms
Тесты включали 50 прогревочных прогонов и 500 измеряемых итераций с использованием синтетических входных данных для измерения задержки вывода и эквивалентного FPS, без учёта обработки изображения с камеры и накладных расходов на постобработку. На приведённом ниже графике сравниваются результаты для трёх устройств и моделей.
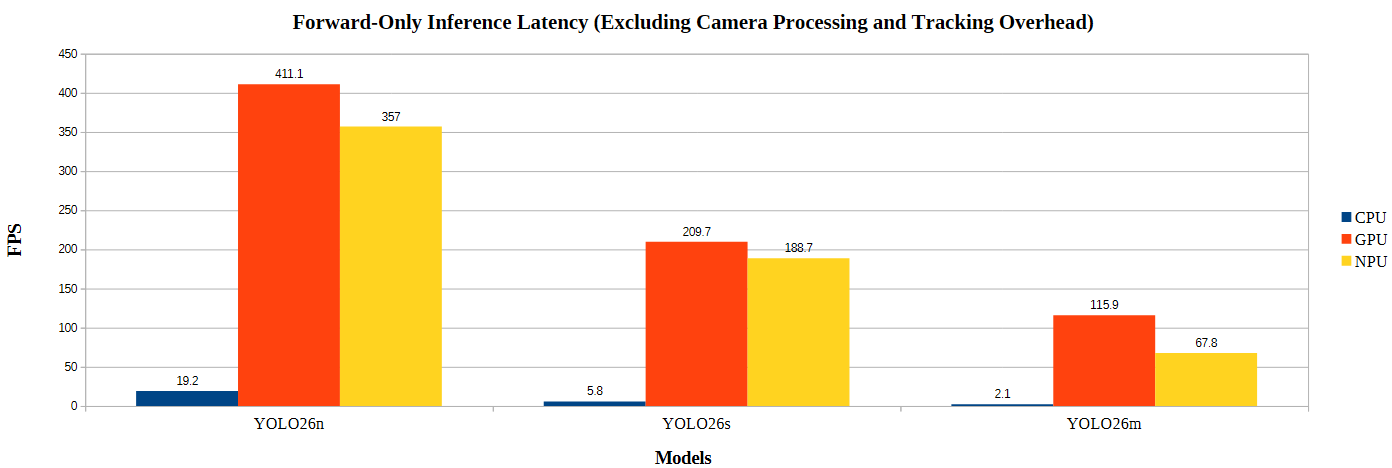
Результаты оказались впечатляющими. GPU Intel Arc показал 411, 210 и 116 FPS для трёх моделей, а NPU выдал 357, 189 и 68 FPS соответственно. CPU оказался значительно медленнее, показав 19,2, 5,8 и 2,1 FPS. Интересно, что NPU превысил заявленные производителем показатели для моделей YOLO26n и YOLO26s, достигнув 152% и 119% соответственно. Эти результаты подчёркивают мощные возможности устройства по ускорению ИИ, хотя указанные значения FPS отражают производительность только при выводе.
Отслеживание YOLO26 и BoT-SORT в реальном времени с помощью веб-камеры
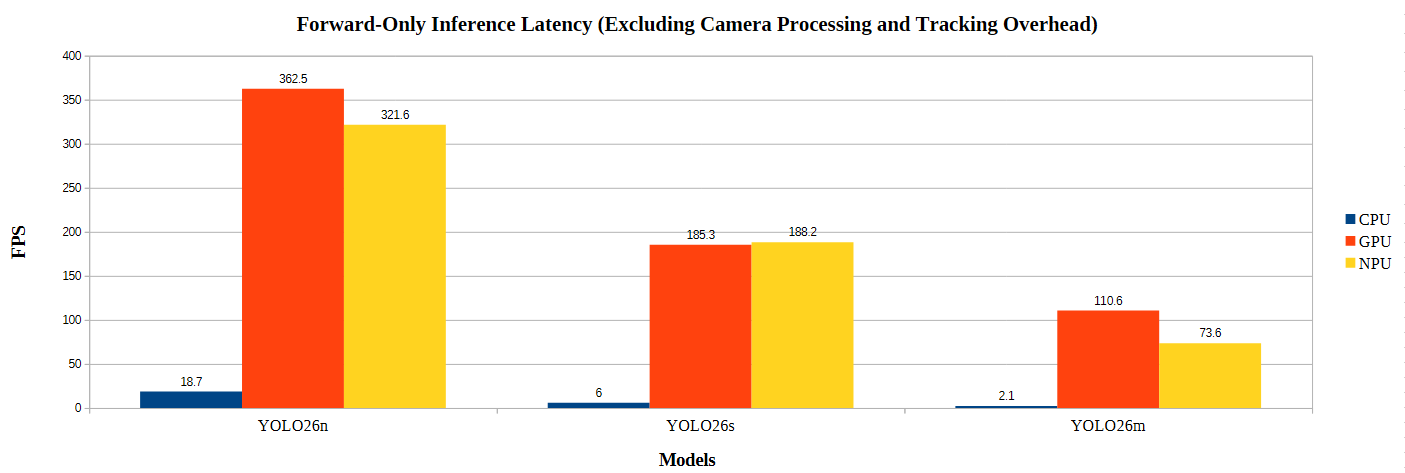
Далее было протестировано обнаружение объектов YOLO26 в реальном времени с отслеживанием BoT-SORT с использованием USB-камеры и OpenVINO на CPU, GPU и NPU. Тест только прямого прохода, в котором не учитывались обработка изображения с камеры и накладные расходы на отслеживание, показал немного более низкую производительность, чем предыдущие тесты. Например, YOLO26n показал 18,7, 362,5 и 321,6 FPS на CPU, GPU и NPU соответственно по сравнению с 19,2, 411,1 и 357,0 FPS в предыдущих тестах.
На приведённом ниже рисунке показана производительность полных тестов с веб-камерой в реальном времени, включая обнаружение объектов YOLO26, отслеживание BoT-SORT и отрисовку интерфейса. На CPU YOLO26n показал около 48,5 FPS, тогда как YOLO26s и YOLO26m снизились до 6,2 и 2,3 FPS соответственно. Переключение на GPU или NPU значительно повысило производительность. Например, YOLO26s вырос с 6,2 FPS на CPU до 145,1 FPS на GPU.
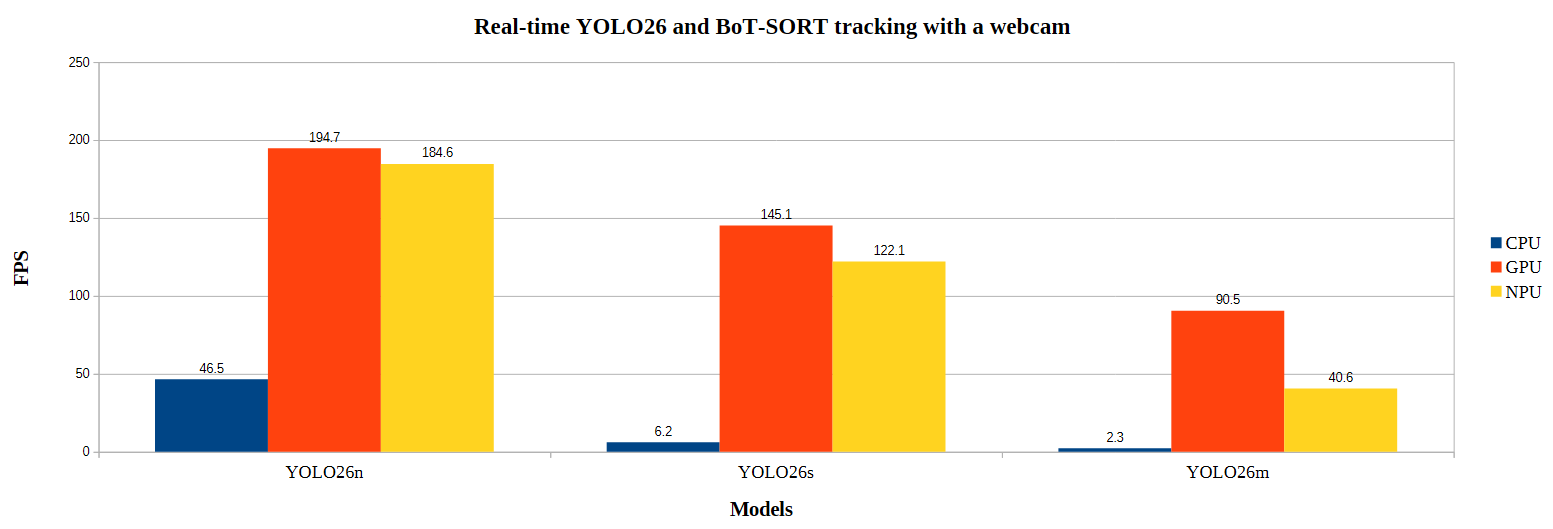 Следует отметить, что условия тестирования контролировались не так тщательно, как в формальных исследованиях, поэтому результаты могут немного отличаться. Однако повторные тесты показали аналогичные тенденции. Кроме того, значения FPS в этом и предыдущем разделе представляют собой эквивалентный FPS, а не фактическую частоту кадров в реальном времени. На практике большинство тестов на GPU и NPU выполнялись со скоростью около 10 FPS, вероятно, из-за ограничений недорогой USB-камеры и других накладных расходов на обработку. На CPU YOLO26n также достиг около 10 FPS, тогда как YOLO26s и YOLO26m снизились до 5,4 и 2,2 FPS соответственно.
Тестирование оценки карты глубины с Depth Anything V2
Далее была протестирована оценка глубины видео в реальном времени с использованием Depth Anything V2 в отдельной среде Python. Затем с помощью ChatGPT был подготовлен простой скрипт Python, который использовал USB-камеру для ввода видео в реальном времени, а NumPy и OpenCV — для обработки и отображения видео. Для этого быстрого теста использовалась модель V2-Base размером примерно 97,5 МБ. Скрипт работал без сбоев, достигая впечатляющих 25–30 FPS при включённом ускорении на GPU.
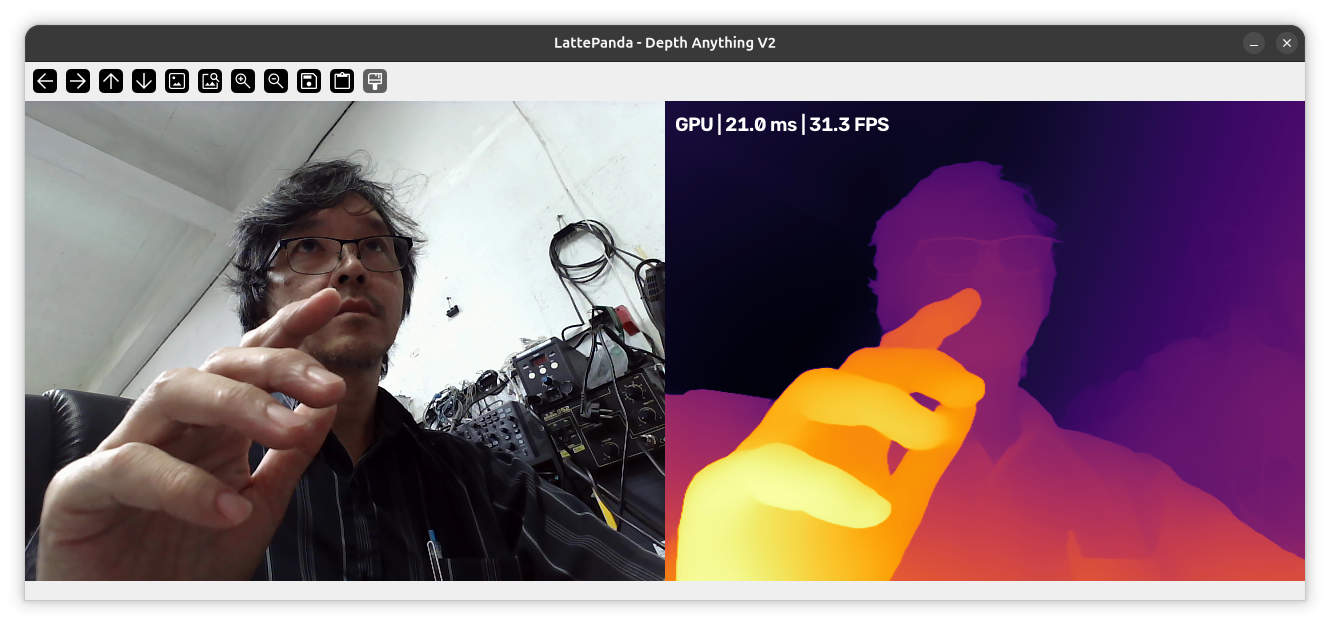
Оценка глубины в реальном времени с Depth Anything V2.Вот короткое видео, демонстрирующее оценку глубины в реальном времени на открытом воздухе.
Демонстрационное приложение: регулировка видео с веб-камеры в реальном времени с помощью жестов рук
Далее для этого обзора было подготовлено финальное демонстрационное приложение, объединяющее обнаружение объектов YOLOv26, отслеживание жестов рук MediaPipe и детекцию ключевых точек лица и тела. Приложение также поддерживает регулировку изображения с веб-камеры в реальном времени с помощью жестов рук. Оно отслеживает обе руки одновременно: левая рука управляет оттенком и насыщенностью, а правая регулирует контраст и яркость. Сведя большой и указательный пальцы вместе, пользователи могут активировать управление, перемещать руки для регулировки изображения и разжать пальцы, чтобы сохранить настройки.
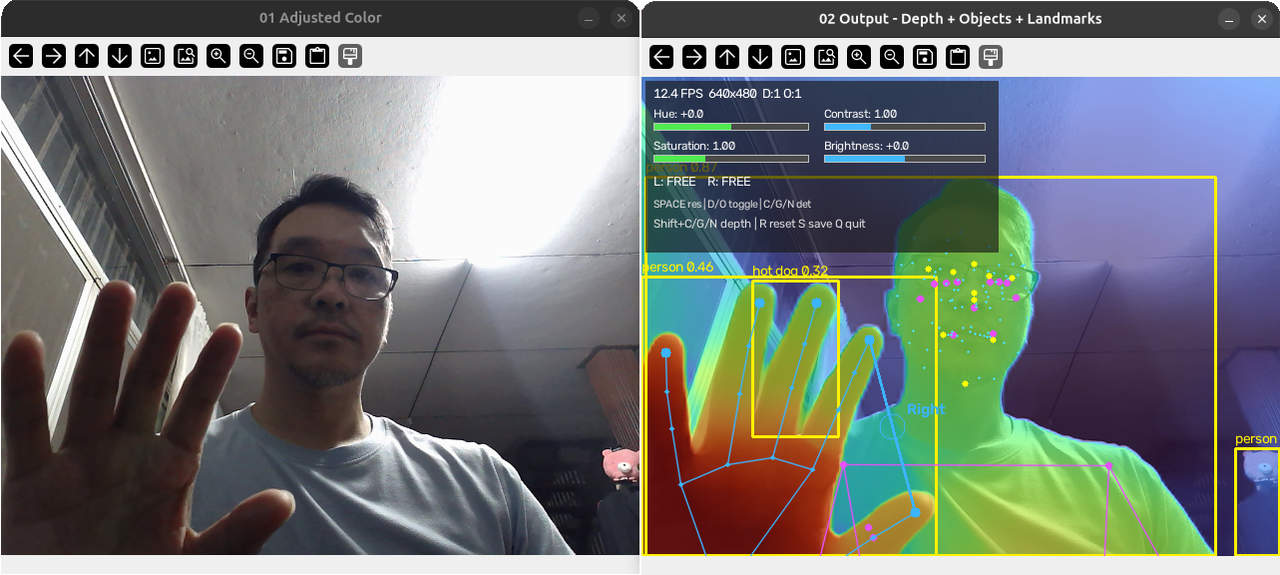
Демонстрационное приложение.Вот короткое видео, демонстрирующее работу приложения в реальном времени. В целом приложение показало хорошие результаты при разрешении по умолчанию 640 × 480, достигая примерно 28–30 FPS. Однако производительность снизилась примерно до 10 FPS при 1280 × 720 и до 5 FPS при 1920 × 1080 из-за возросшей вычислительной нагрузки.
Код Python (сгенерированный ИИ) можно найти на GitHub если интересно.
Заключение
В целом, производительность LattePanda Mu Ultra действительно оказалась вполне удовлетворительной. Настройка оборудования была простой, а установка операционной системы и драйверов — относительно лёгкой. Хотя некоторые инструкции по установке были немного запутанными, большинство возникших трудностей было связано с внешним программным обеспечением и совместимостью с Linux, а не с самим модулем. CPU, GPU и NPU хорошо показали себя в ходе тестирования, что делает LattePanda Mu Ultra интересным вариантом для локальных AI-приложений. Для исследователя этот компактный модуль особенно привлекателен, тем более что сейчас ведётся поиск небольшого компьютера, способного запускать локальные LLM и другие AI-приложения.
В завершение хотелось бы поблагодарить DFRobot за предоставление продуктов для этого обзора. Рассматриваемый здесь комплект для разработки AI LattePanda Mu Ultra 256V можно приобрести за $733 на DFRobot . В комплект входят модуль, мини-плата-носитель и активная система охлаждения. Сам модуль стоит $699.00 с процессором Core Ultra 7 256V или $599 с процессором Core Ultra 5 225V.
Выражаем свою благодарность источнику, с которого взята и переведена статья, сайту cnx-software.com.
Оригинал статьи вы можете прочитать здесь.